Google Geminiのマルチモーダル機能とは?
TL;DR
Google Geminiは、動画、音声、画像、テキストを組み合わせて認識し、文脈や意図を踏まえた推論と生成を行うAIである。発表時のデモでは、映像理解、手書き答案の添削、画像のコード化などが示されたが、性能評価はGoogle側の資料とデモに基づく。
Transcript
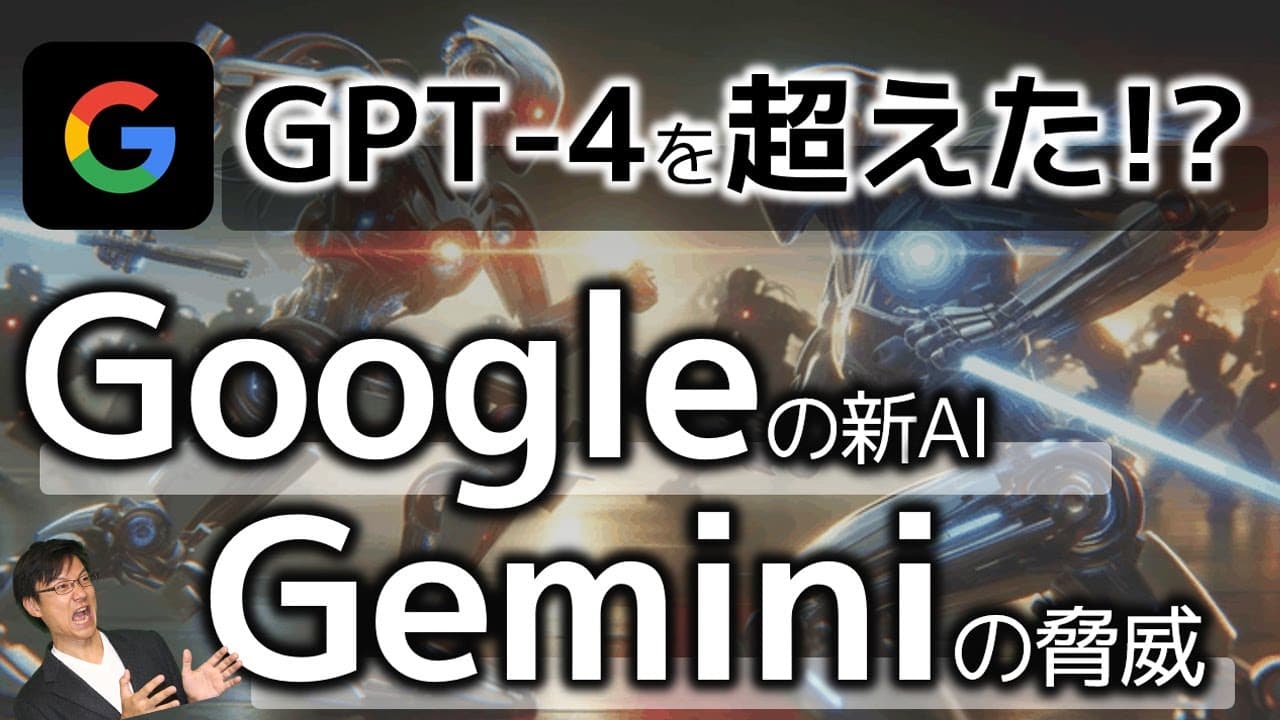
リモ発見球場エトです今回はGoogle のジェミナイがめちゃくちゃすごいという ことで今日12月の7日の朝から非常に 盛り上がっておりましていろんなベンチ マークでもGPT4を超えたとまた対応 できる範囲も動画であったり音声にも対応 していて範囲としてもGPTフレすごいん じゃないかということで界隈で めちゃくちゃ話題になってるので今日は このジェミナに関して何がすごいのか どんなことができるのかというのを Googleが発表したデモ映像を見 ながら考えていきたいと思いますちなみに ちょうど今朝ですねGoogleがこんな 感じでジェミない関連の動画をガガと上げ てましてそう細切りのですね数分ぐらいの 動画が一気に10軟本上がってですねもう すごい気合を感じる流れだったんです けれどもこれ全部... Read More
Key Insights
- ・Geminiは、動画、音声、画像、テキストを組み合わせて処理し、個別の対象認識だけでなく、入力同士の関係や文脈を踏まえた回答を生成できるAIとして紹介された。
- ・映像理解のデモは、手書きの情報、カップの移動、指の動き、並べた物の共通点などを認識し、その場面からゲームの規則や意味を推論する能力を示した。
- ・意図理解のデモは、情報が足りない場合に追加質問をするか、画像付きの候補を先に提示するかをGemini自身が判断し、対話を具体化する流れを示した。
- ・音声と画像の同時入力は、オムレツの作り方を尋ねながら調理中の状態を画像で示すと、その進み具合を踏まえて次の行動や完成状況を回答する例で説明された。
- ・手書き答案の解析は、各回答の正誤を確認するだけでなく、文章と計算過程を読み取り、誤っている箇所を特定して妥当な解き方を説明する用途を示した。
- ・画像のコード化は、提示された木の画像を簡略化したSVGへ変換し、さらにJavaScriptを使った操作可能な表現とコードへ発展させる例として紹介された。
- ・性能比較は、Googleのブログによれば32種類のベンチマーク中30種類でGeminiがGPT-4を上回ったという結果だが、動画は独立検証ではなくGoogle側の発表を基にしている。
- ・モデル構成は、高性能なUltra、一般利用向けとされたPro、スマートフォンなどの端末上で動作する小型のNanoという3種類で、用途と実行環境が分けられている。
- 🎬 このチャンネルの他の動画:
- 📺 このチャンネル: いけともch
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: Google Geminiのマルチモーダル機能とは何ですか?
Google Geminiのマルチモーダル機能とは、動画、音声、画像、テキストなど複数形式の入力を組み合わせて認識し、文脈を踏まえて推論や生成を行う機能である。紹介されたデモでは、映像内の物体や手の動きを理解するほか、音声による質問と画像で示された状況を同時に処理して回答していた。
Q: Geminiは動画をどのように認識できますか?
Geminiは、動画内に現れる物体や手書き情報、対象の移動、手の動きなどを継続的に読み取り、その意味を説明できるものとして紹介された。デモでは、カップゲームで物体の位置を追跡したり、指の動きが示すゲームを推測したり、並べた物の共通点を判断したりした。
Q: Geminiはユーザーの意図をどのように理解しますか?
Geminiは、依頼に不足している情報を見極め、追加質問をするか、先に選択肢を提示するかを判断する仕組みとして説明された。子どもの誕生日会の例では、動物への関心を手掛かりに画像付きの企画案を出し、選ばれた案から作り方や装飾の種類へ対話を発展させた。
Q: Geminiで音声と画像を同時に使う方法は?
音声で質問しながら、判断対象となる画像も同時に入力することで、両方の情報を踏まえた回答を得られると説明されている。オムレツのデモでは、作り方を音声で尋ね、調理中の画像を見せると、Geminiが現在の状態を判断し、まだ完成していないか、完成したかを回答した。
Q: Geminiは手書きの答案を添削できますか?
Geminiは、手書きの問題と答案を画像から読み取り、回答ごとの正誤を確認できるものとして紹介された。さらに、特定の設問について文章と計算過程を調べ、どの計算部分が誤っているかを指摘し、妥当な回答と考え方を説明するデモも示された。実用時の精度はデモだけでは確定できない。
Q: Geminiで画像をプログラムに変換する方法は?
画像を入力し、SVG形式への変換を指示することで、元の形を簡略化した図形データを生成する例が示された。さらにJavaScriptを使って操作可能な表現にするよう依頼すると、動かせる図形と対応するコードを生成した。動画では、将来的なウェブ制作への発展も話者の見通しとして述べられた。
Q: GeminiはGPT-4より高性能なのですか?
Googleのブログを基にした動画内の説明では、32種類のベンチマーク中30種類でGeminiがGPT-4を上回ったとされている。ただし、すべての評価で優位だったわけではなく、動画で提示された比較はGoogle側の資料に基づく。したがって、実際の用途ごとの優劣は個別に試して比較する必要がある。
Q: GeminiのUltra、Pro、Nanoの違いは何ですか?
Ultraは3種類の中で最も高性能なモデル、Proは一般的な利用が想定されるモデル、Nanoはスマートフォンなどの端末上で動く小型モデルとして説明された。動画公開時点では、NanoとProは2023年中、APIは12月13日ごろ、Ultraは2024年初めに提供される見通しとして紹介されていた。
Summary & Key Takeaways
-
Geminiの中心的な特徴は、動画、音声、画像、テキストなどを組み合わせて扱うマルチモーダル能力である。Googleのデモでは、手書きの絵や地図、カップゲーム、指の動きを映像から読み取り、対象の意味や変化をリアルタイムに近い形で説明した。さらに、画像を基に音声や映像を生成し、追加された要素に応じて出力を変える例も紹介された。ただし、これらは公開デモの範囲で確認された能力である。
-
Geminiは、入力を認識するだけでなく、ユーザーの目的に合わせて応答方法を選ぶ仕組みも示した。子どもの誕生日会を考える例では、不足情報を質問するか、先に候補を画像付きで提示するかを判断し、その後はカップケーキの作り方や動物を使った装飾案へ展開した。手書き答案の例では、正誤判定、誤った計算箇所の特定、妥当な解法の説明まで行い、教育支援への応用可能性が示された。
-
発表時の比較では、Googleの資料によればGeminiが32種類のベンチマーク中30種類でGPT-4を上回ったと説明された。一方、動画内でもすべての評価で優位ではないこと、比較情報がGoogleのブログに基づくことが示されている。製品はUltra、Pro、Nanoの3モデルに分かれ、当時はNanoとProが2023年中、APIが12月13日ごろ、Ultraが2024年初めに提供される見通しとして紹介された。
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from いけともch 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator