ファインチューニングを業務で活用する方法
TL;DR
ファインチューニングは、過去の入出力例を既存モデルへ追加学習させ、分類や変換の精度、出力の安定性、処理効率を高める方法である。まずプロンプトを試し、多数の例や例外を毎回渡す必要がある場合に導入を検討する。
Transcript
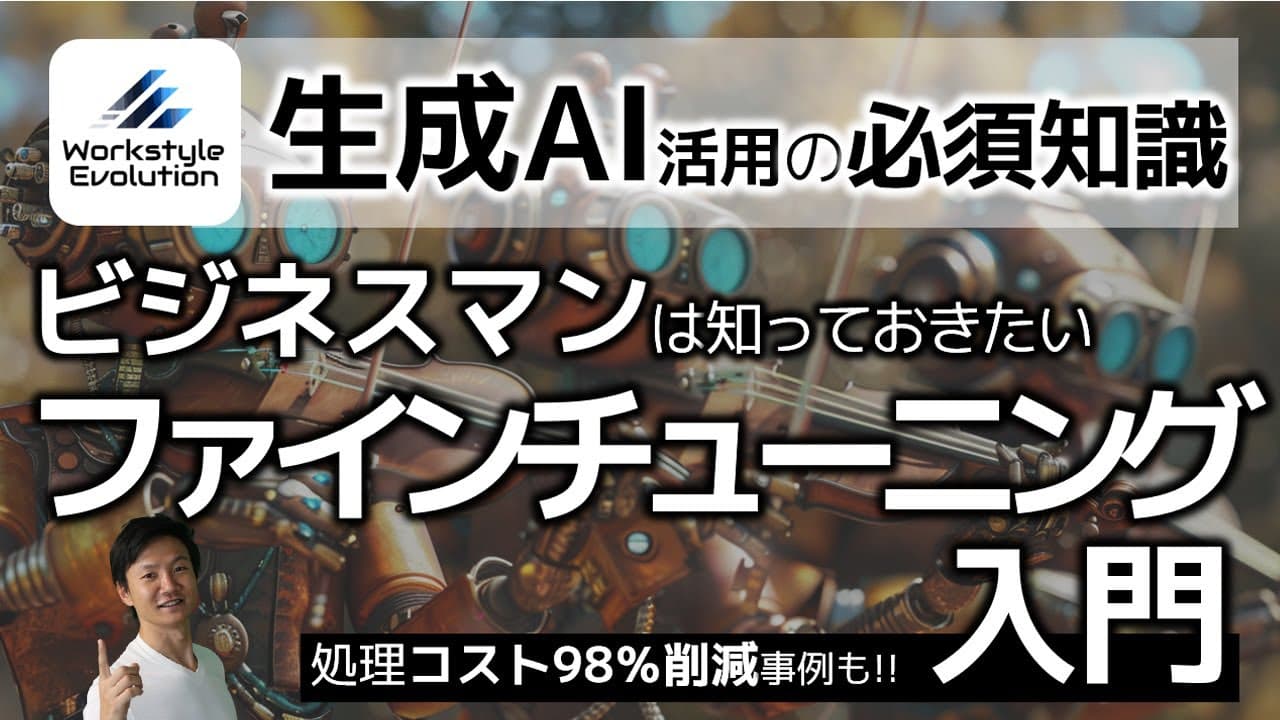
リモートアク研究所えとです今回は生成 活用の必須知識ビジネスマンは知っておき たいファインチューニング入門と題しまし ておそらく皆さん名前は聞いたことあると 思うんですけれどもGPTのモデルであっ たりとか生成AIのモデルをより自分の タスクにフィットした形にするファイン チューニングという手法に関して具体的な 技術面というよりは実際ビジネスでどんな 風に活用できるのかどんなメリットがある のかどんなケスは有効なのかということに フォーカスをしてご紹介できればと思い ます実は最近私ある案件でファイン チューニングやったんですけどもなんと 処理コストがGPT4活用に比べて98% 削減というのを成功した事例もありまして あるシーンではファインチューニング知ら ないとめちゃくちゃ損する話にならない... Read More
Key Insights
- ファインチューニングは、既存の学習済みAIモデルへ特定タスクの入出力例を追加学習させ、用途に適した別のモデルとして利用する技術である。
- RAGは、質問のたびにデータベースを検索して情報をプロンプトへ加える方式であり、ファインチューニングのようにモデル自体を変更する仕組みではない。
- プロンプト最適化は一般的な第一候補であるが、数百の定義や過去事例を毎回含める処理では、入力トークン、費用、待ち時間が増える可能性がある。
- ファインチューニングの価値は、出力を安定させ、多数の例を学習させ、実行時のプロンプトを短縮することでトークン消費と処理時間を抑えられる点にある。
- 紹介された分類案件は、定義表だけでは表現できない長年の過去事例が判断に必要であり、GPT-4系モデルへのプロンプト方式では一致率が約10%だった。
- 紹介事例のファインチューニングは、数百件を学習させ、未使用の数百件で検証した結果、試行段階で約95%の精度を示したと講演者は報告している。
- 紹介事例の処理費用は、講演者の試算でプロンプト方式の1件約2円から約0.05円へ下がり、約98%削減されたが、他の業務でも同じ結果になるとは限らない。
- 適性が高いタスクは、具体例を見せる方が細かな規則を文章化するより伝えやすい分類や変換、文体統一、形式固定、多数の例外を含む処理である。
- 🎬 このチャンネルの他の動画:
- 📺 このチャンネル: いけともch
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: ファインチューニングとは何ですか?
ファインチューニングとは、GPT-3.5 TurboやGPT-4系などの学習済みAIモデルに、特定タスクの入力と望ましい出力の例を追加学習させる方法である。実行時に大量の事例を毎回プロンプトへ書くのではなく、あらかじめ事例のパターンを反映した新しいモデルを作り、そのモデルへ対象データを入力して利用する。
Q: ファインチューニングとRAGの違いは何ですか?
違いは、モデル自体を追加学習するか、回答時に外部情報を検索するかにある。ファインチューニングは事前に入出力例を学ばせたモデルを作る。一方、RAGは質問ごとにデータベースを検索し、取得した情報をプロンプトへ渡して回答を生成するため、AIモデルそのものは変更しない。
Q: ファインチューニングが向いている業務は何ですか?
向いているのは、分類や変換、語調や文体の統一、特定フォーマットへの出力、多数の例外を含む業務である。特に、細かなルールを文章で定義するより、過去の具体例を多数見せた方が判断基準を伝えやすい処理や、定義表だけでは正解を判断できない処理が候補となる。
Q: プロンプトとファインチューニングはどう使い分けますか?
まずは作成が容易で費用対効果も高いプロンプトを試し、指示と少数の例だけで十分な精度が出るなら、そのまま利用する。多数の分類定義や過去事例を毎回入れる必要があり、プロンプトが長大になる場合や、定義だけでは精度が出ない場合には、ファインチューニングを検討する。
Q: ファインチューニングでコストを削減できるのはなぜですか?
実行時に大量の定義や事例をプロンプトへ含めなくてよくなり、入力トークンを減らせるためである。紹介案件では、GPT-4系モデルを使うプロンプト方式が1件約2円、GPT-3.5 Turboのファインチューニング方式が約0.05円という講演者の試算になり、約98%の削減が報告された。
Q: 紹介された分類事例では、どの程度の精度が出ましたか?
試行段階の精度は約95%だったと講演者は報告している。数百件のデータを学習に使い、学習へ含めていない別の数百件で検証した結果である。これに対し、分類定義だけをプロンプトへ含めた初期方式の一致率は約10%であり、過去事例を学習させる方法が有効だった。
Q: OpenAIでファインチューニングする方法は?
学習用の入出力例を準備し、JSONL形式へ変換してOpenAIの管理画面へアップロードし、ベースモデルを選んで学習を実行する。各例は、前提となるシステム指示、ユーザーが渡す入力、AIに期待するアシスタント出力を基本セットとして整理する。完成したモデルはプレイグラウンドやAPIから利用できる。
Q: ファインチューニングには何件の学習データが必要ですか?
講演内で示された最低条件は10サンプルだが、実際に必要な件数は対象タスクの種類やパターン数によって変わる。分類候補や例外が多い場合は、それぞれを学べるだけの必要十分な例を揃える必要がある。紹介事例では数百件を学習に使い、別の数百件を検証に使用した。
Summary & Key Takeaways
-
ファインチューニングは、GPTなどの学習済みモデルへ特定タスクの入出力例を追加学習させ、用途に適した新しいモデルを作る方法である。プロンプトだけで対応する方法や、検索結果を回答時に渡すRAGとは仕組みが異なる。一般的な業務ではまずプロンプトを検討し、質問ごとに参照情報が変わるならRAG、多数の事例から一定の判断や出力形式を学ばせたいならファインチューニングが候補となる。独自LLMの構築は、多くの企業には難度が高い選択肢とされる。
-
講演者が紹介した分類案件では、数百種類の定義と長年蓄積された過去事例があり、定義表だけをGPT-4系モデルのプロンプトへ入れる方法では一致率が約10%にとどまった。そこで数百件の事例をGPT-3.5 Turboへ追加学習し、学習に含めていない数百件で検証したところ、試行段階で精度は95%程度となった。講演者の試算では、1件約2円だったプロンプト方式に対し約0.05円となり、約98%削減されたが、単一案件の結果である。
-
実施手順は、必要十分な学習例を準備し、システム指示、ユーザー入力、期待するアシスタント出力の組み合わせをJSONL形式へ変換し、OpenAIの管理画面で学習を実行する流れである。作成したモデルは画面上のプレイグラウンドまたはAPIから利用できる。向いているのは、分類、変換、文体や語調の統一、特定フォーマットへの出力、多数の例外がある処理、文章だけではルール化しにくい処理であり、学習後も未使用データによる精度検証が必要となる。
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from いけともch 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator