GPT-5で誤回答を減らしアプリを作る方法
TL;DR
GPT-5は質問の難度に応じて計算量を自動調整し、従来モデルより誤回答を抑えながら、短い指示から機能するアプリやウェブサイトを数分で生成できる。博士級の評価性能が日常の便利さに直結するとは限らないが、モデル選択の簡略化とコーディング精度の向上は実用面で大きい。
Transcript
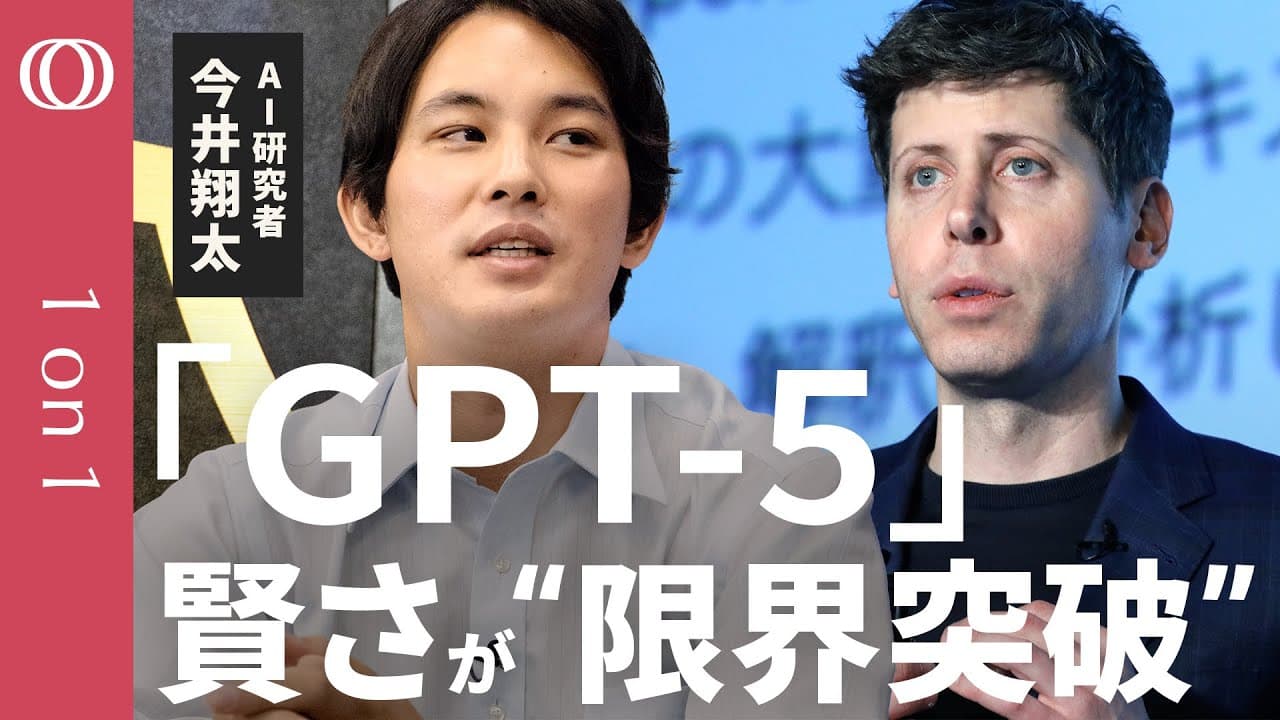
こんにちは。クロスデグの中川です。今日 のワンオンワのテーマはついに登場GPT 5を大解剖です。ま、今収録しているのが 8月8日の午前中なんですけども、今日の 午前2時にOENAIが最新AIモデル GPT5を発表しました。ま、チャット GPTが今後どう進化するのか、そして この最新モデルの登場をどう捉えたらいい のか、今日はこの方に詳しくお伺いしたい と思います。AI 研究者で北陸先端科学技術大学院大学院教授の今翔太さんです。よろしくお願いします。 よろしくお願いします。 先週に引き続き はい。まさかこんな短い感出ると僕思ってませんでした。 本当にちょうど1 週間ではい。再び来ていただいて本当にありがとうございます。もうライブ配信もあのオープンエアのライブ配信もご覧になってから はい。もう2... Read More
Key Insights
- GPT-5は、質問の難度を判定し、長く推論する処理と素早く答える処理を自動的に使い分けるため、利用者が用途ごとにモデルを選ぶ負担を減らす仕組みである。
- 博士号レベルという表現は難問ベンチマーク上の能力を示すものであり、今井氏は、高い知能が日常生活での使いやすさや実用性にそのまま直結するわけではないと指摘している。
- ハルシネーションは、番組で示された複数の評価項目において、O3やO4-miniより低い割合を記録しており、一般利用者が体感しやすいGPT-5の改善点になると今井氏は予測している。
- 誤回答が減った技術的理由は、OpenAIが内部の技術を公開していないため確認不能であり、新しい強化学習や評価器の効果という説明は、今井氏による情報に基づく推測である。
- 人類最後の試験は、各分野の博士号取得者らが生成AIには解けないと考えた難問から構成され、GPT-5は40%台を記録したが、ツール利用条件の違いから単純比較には限界がある。
- コーディング能力は、短い指示から比較サイトを約2分31秒で生成し、絞り込みボタンを含む機能を一貫して動かした実演により、実用上の強みが具体的に示されている。
- ソフトウェア工学ベンチマークの74.9%は高い結果だが、今井氏によればClaude 4.1の約74%台と拮抗しており、数値上で圧倒的な差があるとは判断できない。
- ソフトウェア・オンデマンドは、必要な機能を既製品から探すだけでなく、その場でAIにコードを書かせて実行する考え方であり、個別用途の道具を数分で作れる可能性を示す。
- 🎬 このチャンネルの他の動画:
- 📺 このチャンネル: TBS CROSS DIG with Bloomberg
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: GPT-5で誤回答を減らす方法は?
質問の難度に応じたGPT-5の自動処理を利用することが基本である。GPT-5は、長く考える必要がある質問か、すぐ答えられる質問かを内部で判断すると説明されている。番組で示された評価では従来モデルよりハルシネーション率が低かったが、重要な回答は根拠も確認すべきである。
Q: GPT-5でウェブアプリを作る方法は?
作りたい目的、比較対象、必要な表示や操作を自然な文章で具体的に指示する。実演では、GPT-5とClaudeの比較サイトを作るよう短く頼むと、約2分31秒でコードが生成され、項目を絞り込むボタンを備えたサイトが動作した。公開する場合は、生成コードをサーバー上で実行する必要がある。
Q: GPT-5はなぜモデルを選ばずに使えるのか?
GPT-5自身が質問の内容を見て、必要な思考時間と計算量を判断する仕組みを持つからである。従来は利用者がGPT-4系やO3などから用途に合うモデルを選ぶ必要があったが、GPT-5では内部の振り分けによって、その選択負担を軽減できると説明されている。
Q: GPT-5が博士号レベルとはどういう意味ですか?
難しい数学、科学、専門知識などの評価試験で、博士号取得者に相当する高い能力を示すという意味である。今井氏もカタログ上の評価としては妥当だと認めている。ただし、皿洗いのような日常作業を例に、高い専門知識と生活上の便利さは同じではないとも注意している。
Q: GPT-5のハルシネーションはなぜ減ったのですか?
正確な理由は公開情報だけでは確認できない。OpenAIが内部技術を開示していないためである。今井氏は、答えが明確な数学やプログラミングだけでなく、文章の良さのような曖昧な品質にも学習信号を与える、新しい強化学習や評価器が関係した可能性を推測している。
Q: GPT-5のコーディング性能は他モデルより高いですか?
実演上の完成度は高いが、定量評価で圧倒的とは言い切れない。GPT-5はソフトウェア工学ベンチマークで74.9%を記録した一方、今井氏によればClaude 4.1も約74%台だった。短い指示からUIと機能を一貫して作る能力は高く評価されている。
Q: GPT-5のAPIはどの程度安いのですか?
番組では入力100万トークン当たり1.25ドルと紹介され、トークンを大まかに文字として捉える説明も行われた。比較対象としてClaudeは約3ドルとされており、GPT-5は半額以下に当たる。ただし、この比較は番組内で示された価格と条件に基づく。
Q: ソフトウェア・オンデマンドとは何ですか?
必要な課題が生じた時に、その用途専用のソフトウェアをAIにその場で作らせる考え方である。既製ソフトを探して使い方を合わせるだけでなく、短い指示からウェブサイトや学習アプリなどを生成する。GPT-5の実演では、数分で操作可能な比較サイトが作られた。
Summary & Key Takeaways
-
GPT-5は、入力された質問を見て、長く考えるべきか、すぐ回答してよいかを内部で判断する仕組みを備えると今井翔太氏は解説する。利用者がGPT-4系や推論モデルを選び分ける負担を減らし、必要以上に計算資源を使う状況も抑えられるため、無料ユーザーへの提供やAPI価格の低下を支える要因になった可能性がある。
-
信頼性では、紹介された評価結果において、長文の事実性など複数の項目でハルシネーション率が従来モデルより大幅に低下した。ただし、OpenAIは内部技術を公開しておらず、改善の正確な仕組みは確認できない。今井氏は、曖昧な品質も評価できる新しい強化学習手法が寄与した可能性を、確度のある情報ではなく推測として示している。
-
コーディングでは、GPT-5が短い指示から約2分31秒で比較サイトを作り、表示の絞り込み機能までエラーなく動作させた例が紹介された。一方、ソフトウェア工学ベンチマークは74.9%で、Claude 4.1の約74%台と大差はないという。見た目や一貫した実装への高い評価と、定量的な優位性は分けて判断する必要がある。
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from TBS CROSS DIG with Bloomberg 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator