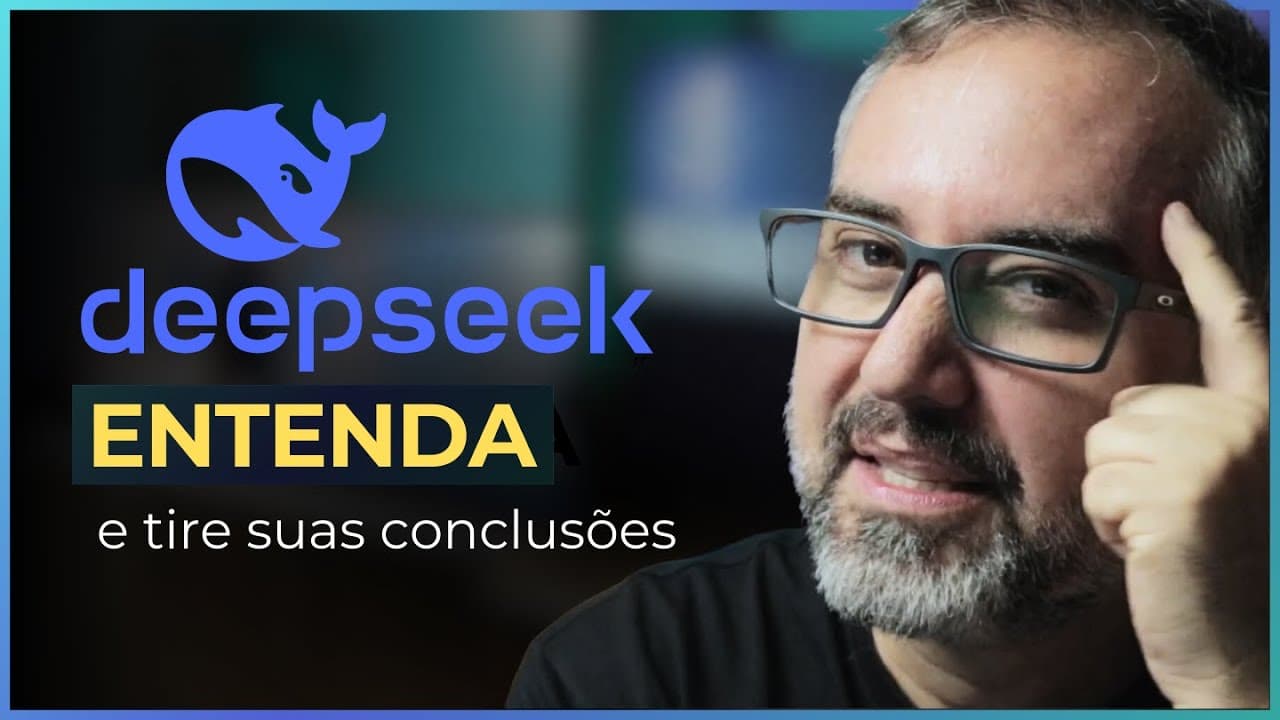
Como o DeepSeek aprende e roda no computador?
TL;DR
O DeepSeek combina aprendizado por reforço, destilação de modelos e cadeia de pensamento para desenvolver sua capacidade de resolver tarefas. A explicação apresenta recompensas para orientar o aprendizado, um modelo maior ensinando modelos menores e etapas de raciocínio para problemas complexos. Versões menores podem funcionar localmente, permitindo usar documentos privados sem depender de uma conexão com a internet.
Transcript
de psique explicado para sua avó não é possível que agora você não entenda como funciona por dentro de psique e como ele foi treinado para conseguir um baixo custo e uma capacidade intelectiva semelhante ao o1 e ao O3 da Open ey Olá tudo bem eu sou o sandeco professor e pesquisador pelo Instituto e Universidade Federal de Goiás Além disso eu sou em... Read More
Key Insights
- O aprendizado por reforço usa recompensas e punições para orientar a melhoria do comportamento do modelo.
- A analogia do xadrez apresenta o aprendizado como uma sequência de tentativas e ajustes progressivos.
- A destilação usa um modelo mais forte como professor para melhorar a capacidade de um modelo menor.
- O DeepSeek R1 é apresentado com 671 bilhões de parâmetros e execução voltada a grandes servidores.
- Uma versão de 8 bilhões de parâmetros é apresentada como alternativa para rodar no computador local.
- A execução local sem internet é apresentada como uma forma de manter documentos privados na máquina.
- O retreinamento com documentos privados é apresentado como uma forma de adaptar o modelo à empresa.
- A cadeia de pensamento detalha etapas de raciocínio para ajudar na resolução de tarefas complexas.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: Quais técnicas explicam o funcionamento do DeepSeek na apresentação?
A apresentação organiza a explicação do DeepSeek em três técnicas: aprendizado por reforço, destilação de modelos e cadeia de pensamento. O aprendizado por reforço é descrito como um processo de melhoria orientado por recompensas e punições. A destilação aparece como a transferência de conhecimento de uma rede maior para uma menor, usando a comparação entre um irmão mais velho e um irmão mais novo. A cadeia de pensamento consiste em detalhar etapas de raciocínio para chegar a uma conclusão. Essas técnicas são usadas para explicar o aprendizado, a criação de versões menores e a resolução de tarefas complexas.
Q: Como funciona o aprendizado por reforço na analogia usada para explicar o DeepSeek?
O aprendizado por reforço é explicado como uma sequência de tentativas em que os resultados orientam o comportamento seguinte. Na analogia do xadrez, o modelo começa como um novato, comete erros e joga repetidamente contra uma cópia de si mesmo. Quando realiza uma ação considerada adequada, recebe uma recompensa; quando erra, recebe uma punição. A apresentação usa essa dinâmica para ilustrar a melhoria progressiva da rede. O exemplo serve para facilitar a compreensão do treinamento com dados, pois o próprio professor pede que o público imagine os textos no lugar das situações de xadrez.
Q: Como o treinamento de uma cachorrinha ajuda a entender o aprendizado por reforço?
O treinamento da cachorrinha Mafalda ilustra como recompensas podem incentivar um comportamento desejado de maneira gradual. O professor conta que primeiro colocou o bambolê perto dela, dentro da cama, para criar uma associação positiva. Depois, posicionou o bambolê no chão e usou um petisco para fazê-la passar de um lado para o outro. Em seguida, aumentou progressivamente a altura do bambolê, continuando a reforçar o comportamento. A relação com as redes neurais está no uso de sinais de recompensa para orientar o aprendizado, tornando mais fácil compreender a lógica apresentada para o DeepSeek.
Q: Como a apresentação compara o treinamento do DeepSeek com o da OpenAI?
A comparação usa uma situação de xadrez para apresentar dois modos de aprender. No exemplo atribuído à OpenAI, o aprendiz consulta um especialista, representado pelo Stockfish, para obter uma avaliação dos movimentos em diferentes posições. O professor associa esse processo ao aprendizado supervisionado e à necessidade de reunir muitas informações antes do treinamento. No exemplo do DeepSeek, o aprendiz joga repetidamente contra uma cópia de si mesmo e melhora com recompensas e punições. Essa comparação é uma analogia didática da apresentação, que usa o tabuleiro para tornar compreensível o aprendizado com dados de texto.
Q: O que é destilação de modelos e qual é sua função no DeepSeek?
A destilação de modelos é apresentada como uma técnica em que um modelo mais forte ajuda a melhorar um modelo menor. O professor compara esse processo a um irmão mais velho ensinando um irmão mais novo a jogar xadrez. Na explicação, a rede maior transmite conhecimento à menor, que aumenta sua capacidade ao longo do treinamento. O exemplo usa o DeepSeek R1 de 671 bilhões de parâmetros como professor e uma rede de 8 bilhões de parâmetros como modelo menor. A finalidade destacada é permitir que versões menores sejam usadas em um computador local.
Q: Qual é a diferença entre os modelos de 671 bilhões e 8 bilhões de parâmetros apresentados?
A apresentação distingue os modelos principalmente pelo tamanho e pelo ambiente de execução. O DeepSeek R1 de 671 bilhões de parâmetros é descrito como uma rede grande, que funciona em servidores e não pode ser colocada no computador pessoal no cenário apresentado. A versão de 8 bilhões de parâmetros aparece como uma rede menor, capaz de funcionar localmente e treinada com ajuda da rede maior por destilação. A explicação associa essa redução à possibilidade de levar o modelo para a máquina do usuário. O trecho fornecido não especifica os requisitos de equipamento para executar essa versão.
Q: Quais vantagens a apresentação atribui ao uso local do DeepSeek com documentos privados?
O uso local é apresentado como uma forma de trabalhar com documentos privados em uma máquina que pode ficar desconectada da internet. O professor também descreve a possibilidade de retreinar a rede com arquivos próprios ou documentos empresariais, para que ela responda com base nesse conteúdo. Os exemplos incluem um tribunal de justiça e uma empresa com segredos industriais. A proposta é manter a documentação e o acesso ao modelo sob controle de quem o utiliza. A proteção descrita depende do cenário mencionado na apresentação, com a rede protegida e o acesso restrito aos usuários autorizados.
Q: O que é cadeia de pensamento e como ela ajuda a resolver tarefas complexas?
A cadeia de pensamento é descrita como uma técnica que organiza e explicita etapas de raciocínio durante a resolução de uma tarefa. Em vez de apresentar apenas uma resposta direta, o modelo encadeia etapas até chegar a uma conclusão. O professor relaciona essa abordagem à resolução de problemas mais complexos e menciona os pensamentos mostrados durante o uso do DeepSeek na interface web. Também apresenta a ideia de fornecer uma pergunta, sua resposta e o raciocínio utilizado para alcançá-la. O trecho fornecido termina durante a introdução desse exemplo, sem mostrar a demonstração completa.
Summary & Key Takeaways
-
O aprendizado por reforço é explicado com analogias de xadrez e treinamento de cães: erros recebem punições e comportamentos desejados recebem recompensas, orientando a melhoria progressiva do modelo.
-
A destilação transfere conhecimento de um modelo maior para modelos menores. O exemplo apresentado relaciona o DeepSeek R1 de 671 bilhões de parâmetros a uma versão de 8 bilhões para execução local.
-
A cadeia de pensamento organiza etapas de raciocínio para resolver tarefas complexas. A execução local é apresentada como opção para trabalhar com documentos privados e adaptar o modelo a uma empresa.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚


Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator