国産フィジカルAIで日本が挽回する方法
TL;DR
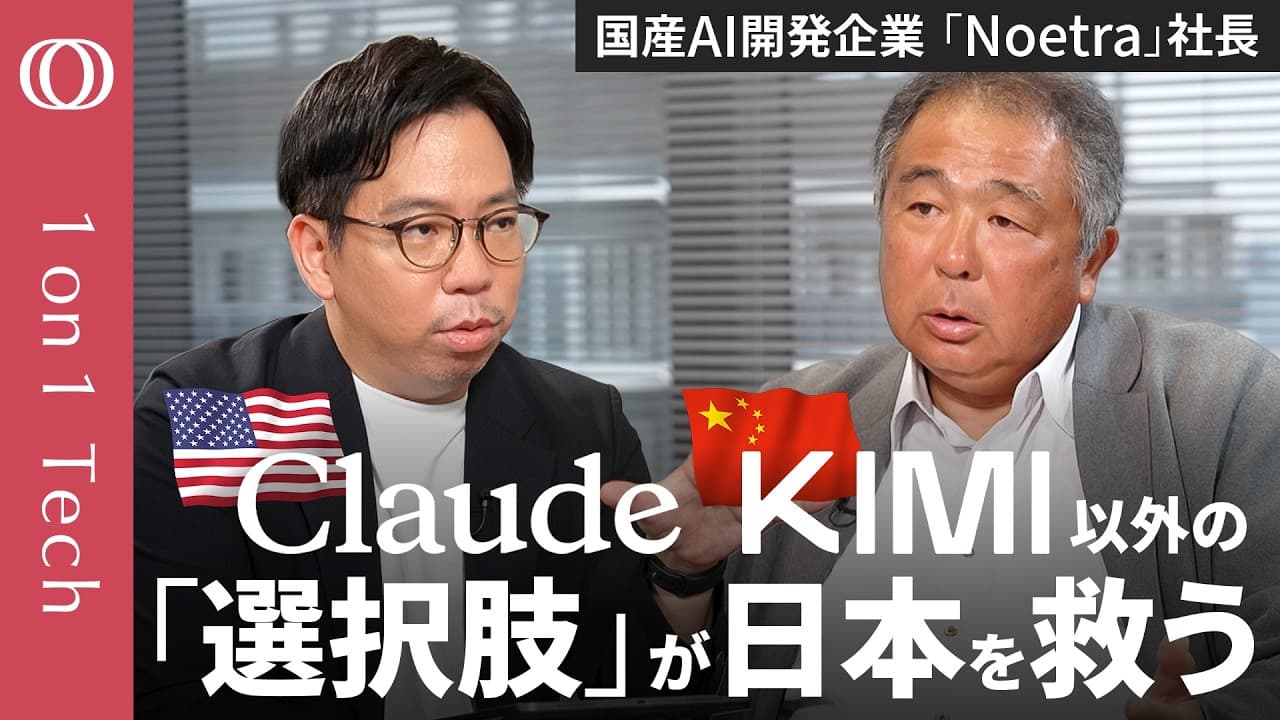
日本は米中のAIだけに依存せず、自国で管理できる基盤モデルを選択肢として確保する必要がある。ノエトラは国内企業の人材と計算資源を集約し、基盤モデルを追随開発したうえで、製造業とロボットを生かせるフィジカルAIで世界上位を目指す。
Transcript
ワンオンワンテック始まります。今日の テーマは[音楽]国産AIノエトラの野望 です。AI開発競争で遅れを取った日本 ですけども、政府が最大[音楽]1兆円を かけて国産フィジカルAIの開発に 乗り出しました。その中核を担うのが国内 44[音楽]社が出資した開発企業 ノエトラです。2万7500機以上の NVIDIAの最新[音楽]GPUを導入 して世界で勝てるAIモデルの開発を始め ます。 今日はノエトラの田波広信社長にこの国産 AI プロジェクトが立ち上がった背景と今後の戦略について伺います。田さんよろしくお願いします。 [音楽] あ、よろしくお願いします。 ちょっとあのクロスデ 3 つの大きなトピッのをこう設けてインタビューをお届けしてるんですけども、今日その [音楽] 3つがですね、1つがな... Read More
Key Insights
- 国産AIは、海外製モデルを排除するためではなく、利用停止や規制変更を受けた場合にも日本が交渉できる代替選択肢を確保するための基盤である。
- AI主権は、モデルの保有だけでなく、国内データの管理、追加学習を続ける技術、内部を検証して問題へ対処できる透明性によって成立する。
- 最先端モデルの首位維持は、大量の人材、計算機、電力に加え、完成までの多数の失敗実験を負担できる資源が必要なため、日本には難度が高い。
- 日本の現実的な戦略は、公開論文や既知の技術を使って失敗実験を減らし、基盤モデルを世界上位の水準まで効率的に追い上げることである。
- フィジカルAIは、世界的な首位がまだ固定されておらず、日本の製造業や産業用ロボットを適用先と学習の循環に使える有望な競争領域である。
- ノエトラの基盤モデルは、他国のモデルから合成データを作る依存構造を避け、領域特化型やタスク特化型AIを生み出す上流モデルを目指す。
- 実世界モデルは、言語、音声、画像、動画だけでなく、符号情報、時系列情報、地理空間情報やロボット制御の知識まで扱う必要がある。
- ノエトラは、国内44社の出資、2万7500基以上の最新GPU、約100人の開発陣を集約し、分散していた人材と計算資源を一体化する構想である。
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: なぜ日本に国産AIが必要なのですか?
米国や中国が管理するAIだけに依存すると、規制変更や利用停止が起きた際、日本で使っているにもかかわらず日本側で判断できない恐れがあるためです。国内で管理できるモデルを代替選択肢として持てば、一方的な条件を受け入れる状況を避け、交渉力を確保できます。
Q: AIにおける主権とは何ですか?
AIの主権とは、日本で管理するデータを用いてモデルを作り、追加学習や改良に必要な技術を国内に維持し、内部の透明性を確保することです。著作権などの問題が発生した場合にも、ブラックボックスの海外モデルへ任せず、自分たちで原因を確認して対処できる状態を含みます。
Q: 日本が最先端AIで追いつく方法は?
公開された論文や技術情報を活用し、すでに判明している手法を取り入れて失敗実験の回数を減らす方法です。最先端モデルの開発では完成品一つの計算量だけでなく、その前に重ねる多数の失敗にも資源が必要です。まず効率的に追随し、世界上位の出発点へ到達することが現実的な戦略です。
Q: なぜフィジカルAIが日本の勝ち筋なのですか?
フィジカルAIは、どの企業や国が世界一位になるかがまだ定まっておらず、新しい手法が試されている領域だからです。日本には世界市場で競争力を持つ製造業や産業用ロボットがあり、AIの適用先を確保できます。現場から得た反応でAIを改善し、改善したAIで産業を強くする循環も作れます。
Q: ノエトラはどのようなAIモデルを作るのですか?
言語だけでなく、音声、画像、動画、符号情報、時系列情報、地理空間情報などを扱い、フィジカルAIの土台となる大規模なマルチモーダル基盤モデルです。特定領域や特定業務のAIを作る際に必要な合成データや知識を供給できる、上流のモデルとして自社管理することを目指しています。
Q: なぜ既存の海外オープンモデルでは不十分なのですか?
中国などの公開モデルから合成データを作り、それを別のモデルへ学習させても、上流では海外モデルへの依存が残るからです。また、元のモデルから何が抽出されたかを正確に判定することも難しくなります。ノエトラは大元から管理し、モデルと学習データの中身を把握できる状態を作ろうとしています。
Q: ノエトラの開発体制はどうなっていますか?
国内44社が出資し、各社などから集まった約100人が開発を始めています。人員は主にAIモデルそのものの開発、構築に必要な基盤部分の開発、データセットの準備という三分野を担当します。さらに世界の研究者へ将来を見据えた研究を依頼し、成果を開発へ継続的に反映する体制です。
Q: 政府の最大1兆円規模の支援は何に使われるのですか?
説明では予算の大部分が計算機に充てられ、2万7500基以上のエヌビディア製最新GPUを導入する計画です。従来は国内各社の計算機が分散し、一つの大規模な計算資源として動かせませんでした。今回は計算機と人材を集約し、大規模モデルの開発に必要な計算量を確保します。
Summary & Key Takeaways
-
国産AIが必要な最大の理由は、米国や中国が管理するモデルへの全面的な依存を避けることにある。海外のAIが日本社会へ深く組み込まれた後、利用停止や規制を交渉材料にされれば、日本側だけでは判断できない。モデルを自国で管理すれば、データ主権と技術を維持し、追加学習や著作権問題への対処、内部の透明性確保も自ら進められる。
-
日本が汎用的な最先端モデルで継続的に首位を守るには、人材、計算機、電力などの資源が不足している。そこでノエトラは、公開された論文や技術情報を利用して実験回数を抑え、まず基盤モデルの水準を追い上げる。その後、まだ世界的な勝者が定まっていないフィジカルAIへ集中し、製造業や産業用ロボットとの相互強化を狙う。
-
ノエトラは国内44社の出資を受け、2万7500基以上のエヌビディア製最新GPUを導入する計画である。開発開始時点では約100人が集まり、AIモデル、基盤部分、データセットの三分野を担当する。各社に分散していた人材と計算資源を一つに集約し、世界の研究者による先行研究も開発へ反映する体制を築いている。
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from TBS CROSS DIG with Bloomberg 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator