Como detectar fake news com Orange Canvas
TL;DR
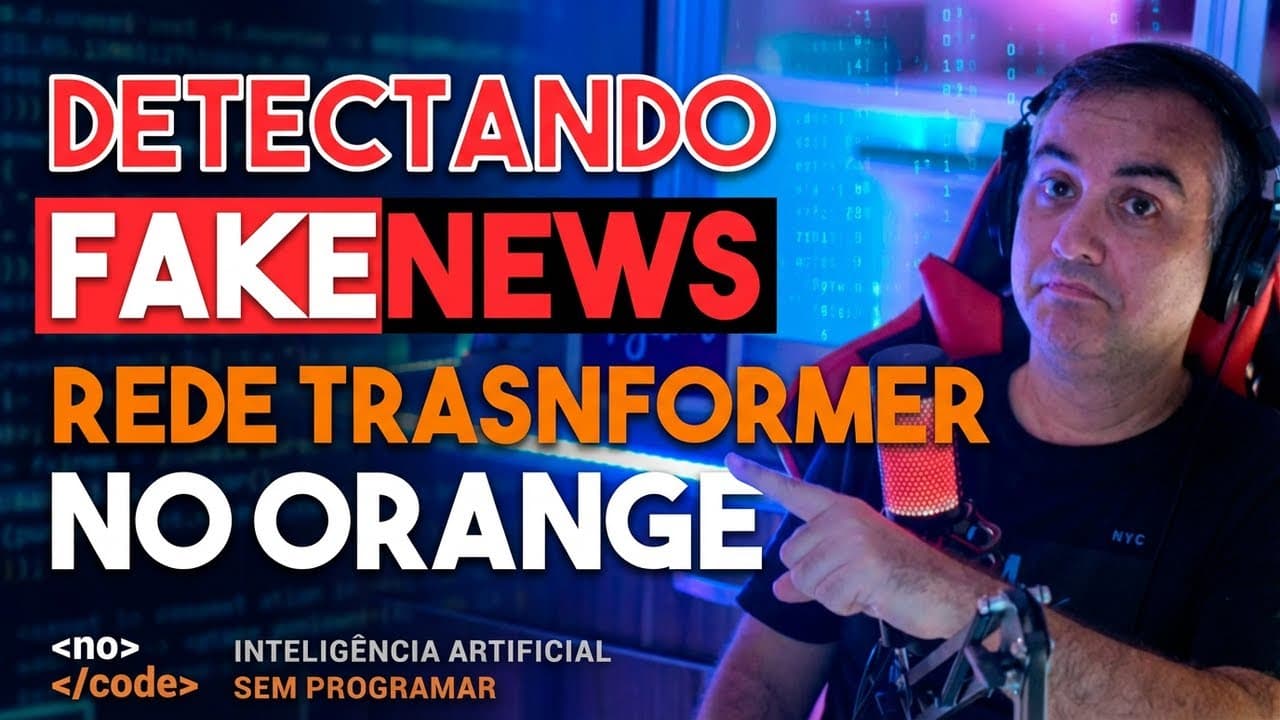
Usei uma base de dados com fake e real news para treinar modelos no Orange Canvas, comparando técnicas como Bag of Words e embeddings com a rede BART Transformer. O método mostrou que embeddings costumam melhorar a acurácia, e que a escolha de termos frequentes influencia bastante a classificação. O vídeo demonstra etapas práticas, balanceamento de classes e avaliação com matriz de confusão.
Transcript
fake News como é que a gente vai detectar fake News usando o Orange Canvas então logicamente primeira coisa que a gente precisa é de uma base de dados E aí a base de dados que eu vou usar é uma base dados que o próprio óleo de peso modificação e eu tenho como base ela é feita com base nesta base de dados aqui do kevball né uma base de dados com Fak... Read More
Key Insights
- Base de dados de fake e real news é usada para treinar o modelo, com o conjunto de treino e teste separados
- Document embeddings com FastText e Transformer são considerados mais potentes que bag of words
- Acurácia inicial da regressão logística fica razoável, com possibilidades de melhoria ao remover termos muito frequentes
- As palavras dominantes como names de pessoas e termos políticos influenciam fortemente a classificação
- A matriz de confusão ajuda a entender como o modelo classifica fake e real separadamente
- Curvas ROC permitem comparar o desempenho de diferentes algoritmos visualmente
- O balanceamento de classes é importante para não privilegiar uma classe
- Pré-processamento com tokens e remoção de números facilita a classificação dos textos
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: Pergunta real de pesquisa sobre o vídeo (ex. 'Como...', 'O que é...?', 'Por que...?'). Pergunta 1
Como o Orange Canvas pode ser usado para detectar fake news a partir de uma base de dados com textos em inglês e como isso se compara com abordagens tradicionais de NLP? O vídeo descreve a montagem de dois conjuntos, treino e teste, e a aplicação de transformações de pré processamento, como minúsculas, tokenização e remoção de stop words. Em seguida, são criadas representações com bag of words e embeddings, e dois modelos são avaliados. A análise mostra que embeddings tendem a oferecer maior poder discriminatório, especialmente quando se utiliza redes de transformação, como o modelo BART, para capturar dependências semânticas entre termos. A comparação entre algoritmos é visualizada por meio de uma matriz de confusão e curvas ROC, destacando como a escolha da técnica de representação afeta a acurácia e a capacidade de detectar notícias falsas. Esse processo evidencia que a prática de balancear as classes também impacta o desempenho final dos modelos, reforçando a importância de um pipeline de dados bem desenhado.
Q: Pergunta 2
Quais etapas de pré processamento são destacadas no vídeo e por que elas são importantes para a qualidade do modelo de detecção de fake news? O vídeo enfatiza transformar o texto para caixa baixa, tokenização, remoção de números e stop words para reduzir ruído. Esses passos ajudam a padronizar o input, reduzir dimensionalidade e evitar que termos de pouca relevância distorçam o modelo. A escolha entre Bag of Words e embeddings é apresentada como a decisão central, onde embeddings, especialmente com transformadores, capturam contexto e relações semânticas entre palavras que o método de contagem simples não consegue. O vídeo também demonstra que manter informações relevantes, como termos políticos, pode ser decisivo para distinguir fake de real, desde que o pipeline trate de forma adequada essas palavras-chave.
Q: Pergunta 3
Como é feito o balanceamento de classes e por que ele importa na detecção de fake news, de acordo com o vídeo? O vídeo descreve verificar a distribuição entre fake e real no conjunto de treino para garantir que não haja viés de classe. O balanceamento evita que o modelo aprenda a favorecer uma das categorias, o que seria especialmente prejudicial na detecção de fake news, onde falsos negativos podem ter consequências graves. Com o conjunto balanceado, a avaliação de acurácia, precisão e outras métricas fica mais confiável. A demonstração inclui a visualização da matriz de confusão, mostrando quantos exemplos de fake e real são corretamente ou incorretamente classificados, e reforça que o balanceamento, aliado a uma boa representação de texto, é essencial para melhorar a performance geral.
Q: Pergunta 4
Que papel as palavras dominantes desempenham na classificação entre fake e real, segundo o vídeo, e como isso afeta a avaliação do modelo? O vídeo aponta que palavras como nomes de pessoas, termos políticos e eventos históricos aparecem com frequência e têm grande poder discriminatório. Quando esses termos são incluídos nas features, eles ajudam o modelo a distinguir entre fake e real com maior precisão. No entanto, se a frequência de palavras dominantes não for gerenciada adequadamente, pode ocorrer viés ou ruído, reduzindo a eficácia. O vídeo mostra que ajustar a inclusão de termos frequentes pode drasticamente alterar a curva ROC e a matriz de confusão, destacando a sensibilidade do modelo a termos específicos que carregam significado contextual.
Q: Pergunta 5
Qual é a comparação entre regressão logística e um modelo baseado em embeddings no vídeo, e qual resulta em melhor desempenho? O vídeo compara regressão logística com um modelo que usa embeddings. A regressão logística apresenta acurácia razoável, mas o vídeo sugere que os embeddings, especialmente com redes de transformação, tendem a oferecer desempenho superior. A curva ROC e a matriz de confusão são usadas para demonstrar que o modelo com embeddings é mais estável e preciso em detectar fake news, embora possa exigir maior poder computacional. A conclusão é que a escolha do modelo depende de objetivos de desempenho e dos recursos disponíveis, mas embeddings geralmente superam métodos puramente contáveis.
Q: Pergunta 6
Quais ferramentas e recursos adicionais são mencionados no vídeo para facilitar a detecção de fake news com Orange Canvas? O vídeo menciona trabalhar com uma base de dados disponível, o link para baixar a base e o repositório no GitHub onde os materiais são disponibilizados. Também é citado o uso de Widgets do Orange Canvas, pré-processadores, variáveis de entrada como textos e rótulos, além de opções de visualização como nuvem de palavras, matriz de confusão e curvas ROC. Esses elementos ajudam o usuário a replicar o fluxo de trabalho, compreender o impacto de cada etapa e ajustar o pipeline para melhorar a acurácia. A ideia central é democratizar o acesso a ferramentas de IA sem programação para detectar fake news.
Q: Pergunta 7
Como o vídeo descreve a diferença entre dados de treino e teste no contexto da detecção de fake news e por que isso importa? O vídeo mostra a separação entre treino e teste para avaliar a capacidade de generalização do modelo. O conjunto de treino é utilizado para ajustar os hiperparâmetros e aprender padrões, enquanto o conjunto de teste serve para medir a performance em dados não vistos. Esta prática é fundamental para evitar overfitting e para fornecer uma estimativa realista de quão bem o modelo poderia operar em novas notícias reais ou falsas. O vídeo também demonstra que a pré-processação aplicada aos dois conjuntos deve ser consistente para manter a validade da avaliação.
Q: Pergunta 8
Que conclusão final o vídeo sugere sobre o uso de orange canvas para detecção de fake news com base nos resultados apresentados? A conclusão enfatiza que é possível construir um fluxo de trabalho eficaz sem muita experiência em programação, usando Orange Canvas para transformar textos, gerar embeddings, treinar modelos simples como regressão logística e avaliar com métricas padrão. O vídeo demonstra que, com a correta seleção de representações, balanceamento de classes e visualizações de desempenho, é viável obter resultados úteis na tarefa de detecção de fake news, encorajando o usuário a experimentar e adaptar o pipeline conforme a necessidade.
Summary & Key Takeaways
-
O vídeo apresenta uma abordagem prática de detecção de fake news usando Orange Canvas com dados de fake e real news, incluindo etapas de pré processamento e escolha entre técnicas de representação de texto.
-
A comparação entre Bag of Words e documentos embeddings mostra que o segundo tende a oferecer desempenho superior, particularmente com redes de transformação.
-
A avaliação do modelo envolve balanceamento de classes, construção de predições, matriz de confusão e leitura de curvas ROC para entender o desempenho dos algoritmos.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator