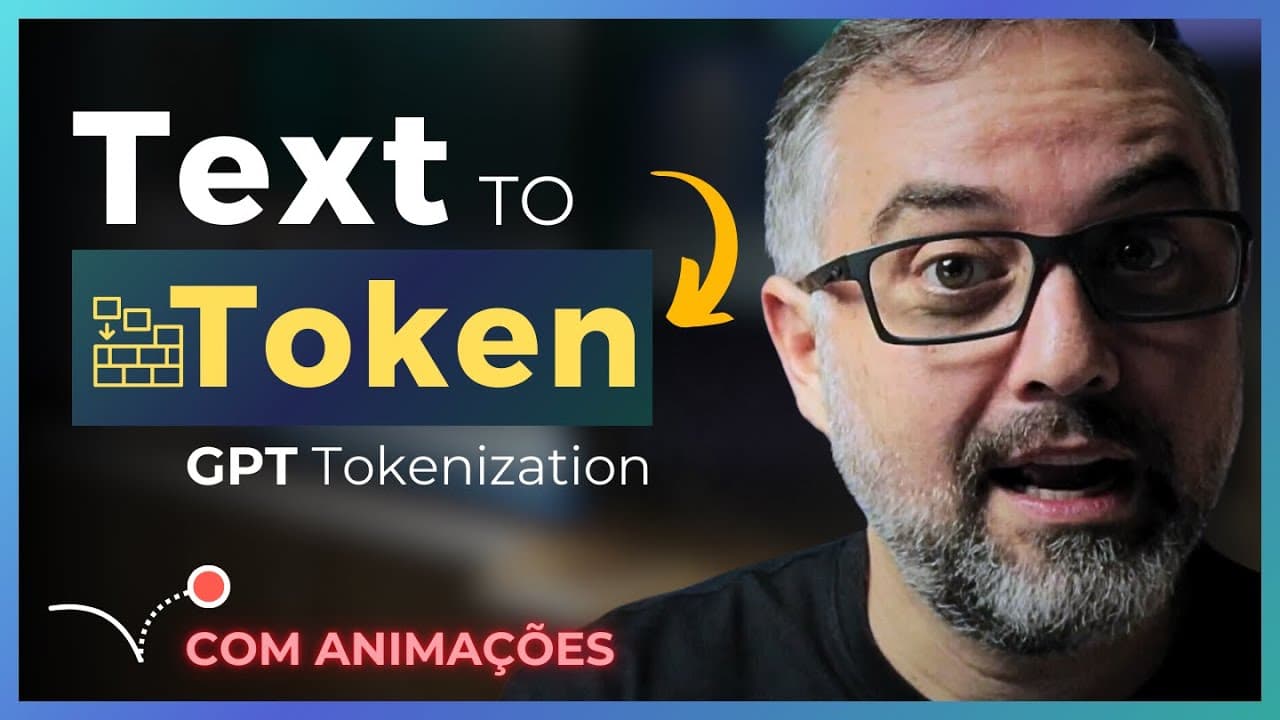
Como a tokenização transforma texto para o GPT?
TL;DR
A tokenização divide o texto em unidades chamadas tokens, que podem corresponder a palavras, partes de palavras ou caracteres. Na demonstração do BPE, unidades adjacentes frequentes são unidas repetidamente para formar tokens. Esse processo prepara o texto para o processamento numérico das redes neurais e ajuda a entender como o GPT usa tokens de entrada para prever os próximos tokens de uma resposta.
Transcript
muito bem vamos continuar nossa série sobre Transformer hoje vou falar sobre esse algoritmo Maravilhoso aqui e o algoritmo do do bpe onde a gente vai aprender sobre tokenização e a importância do tokenização Olha eu quero falar né falar para vocês por que que uma pessoa leiga deveria pelo menos entender e aprender melhor sobre a tokenização sobre o... Read More
Key Insights
- Tokens podem corresponder a palavras, partes de palavras ou caracteres, conforme a divisão do texto.
- A tokenização prepara o texto para redes neurais, cujo processamento trabalha com números.
- A completação usa tokens de entrada para prever os próximos tokens e construir uma resposta.
- O exemplo de BPE começa com texto em minúsculas e separa os caracteres antes de contar pares.
- O BPE demonstrado une o par mais frequente e refaz a contagem das unidades após cada união.
- Uma unidade já agrupada pode integrar um novo par, permitindo formar tokens progressivamente.
- A palavra gol aparece em contextos diferentes quando associada a avião ou a uma partida.
- A aula apresenta os tokens como fundamento dos embeddings, tema anunciado para a aula seguinte.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: O que são tokens e por que eles não são necessariamente palavras?
Tokens são unidades resultantes da divisão de um texto durante a tokenização. Eles podem corresponder a palavras, partes de palavras ou até caracteres, conforme a explicação apresentada. A demonstração separa inicialmente as palavras em caracteres e depois agrupa unidades frequentes. Assim, uma palavra pode aparecer dividida em diferentes tokens, enquanto um token também pode coincidir com uma palavra inteira. Essa coincidência não torna os conceitos equivalentes. O exemplo com te mostra justamente uma unidade formada pelo agrupamento que também corresponde a uma palavra presente na frase.
Q: Por que a tokenização é importante para o processamento de texto pelo GPT?
A tokenização é importante porque prepara a linguagem escrita para o processamento das redes neurais. A explicação parte da diferença entre seres humanos, que lidam bem com palavras, e computadores, que trabalham com números. Dividir o texto em tokens permite estabelecer essa ligação entre os dois tipos de representação. A aula também apresenta os tokens como fundamento para a construção dos embeddings. Na explicação inicial, a tokenização é descrita como um passo essencial para que modelos de linguagem processem o texto de maneira eficaz e produzam respostas coerentes.
Q: Como funciona o BPE no exemplo de tokenização apresentado?
O BPE é demonstrado por meio de uma sequência de separações, contagens e agrupamentos. No exemplo, o texto é colocado em minúsculas e as palavras são divididas em caracteres. Em seguida, são contados os pares adjacentes que aparecem nas unidades analisadas. O par mais frequente é unido, passando a funcionar como uma unidade. Depois dessa alteração, os pares são contados novamente, e outro agrupamento é realizado. A repetição desses passos mostra como partes inicialmente separadas podem formar tokens maiores. A explicação usa uma frase com sorvete, chocolate e chiclete para tornar os agrupamentos visíveis.
Q: Por que é necessário contar os pares novamente após cada união no BPE?
A contagem precisa ser refeita porque cada união modifica as unidades disponíveis para os próximos agrupamentos. Depois que caracteres são unidos, o resultado passa a ser tratado como uma unidade no exemplo. Essa unidade pode aparecer ao lado de outra e formar um novo par frequente. A demonstração destaca esse comportamento quando te já está agrupado e passa a participar de uma combinação com e, formando ete. Portanto, as etapas seguintes consideram a estrutura produzida pelos agrupamentos anteriores. A repetição da contagem acompanha essas mudanças e orienta a próxima união.
Q: Qual é a relação entre tokenização e a geração de respostas por completação?
A completação é apresentada como uma tarefa que utiliza tokens de entrada para fazer previsões dos próximos tokens. A tokenização organiza o texto fornecido em unidades que participam desse processo. O exemplo usado é uma pergunta sobre a capital do Brasil, mostrada de forma particionada, seguida da resposta Brasília. A explicação conecta, portanto, a preparação da pergunta em tokens à previsão das unidades que compõem a saída. Entender essa relação ajuda a acompanhar a descrição da geração de respostas: o modelo recebe uma sequência de tokens e faz previsões para continuar essa sequência.
Q: Quais limitações a aula atribui ao mapeamento direto de palavras para números?
A aula apresenta o mapeamento direto de palavras para números como uma tentativa inicial de aproximar texto e processamento numérico. A limitação destacada envolve a normalização e o efeito de valores muito grandes no processamento da rede neural. Segundo a explicação, esses valores podem prevalecer e influenciar a saída. O exemplo também chama atenção para o contexto: gol associado a avião remete a uma empresa aérea e transporte, enquanto gol associado a partida remete ao futebol. Essas associações são usadas para mostrar a necessidade de uma representação que considere as relações entre palavras.
Q: O que é a codificação one-hot e qual problema é apontado na aula?
A codificação one-hot é descrita como uma representação de cada palavra por um vetor com zeros e um valor um na posição correspondente àquela palavra. As demais posições recebem zero. A aula observa que o vocabulário representado dessa maneira pode ser muito grande. Na comparação visual apresentada, as palavras continuam distantes umas das outras, e essa estrutura é descrita como tendo falta de contexto. As associações entre gol, partida e avião servem para ilustrar o problema. Os embeddings são introduzidos como uma forma mais interessante de representar essas relações, tendo os tokens como fundamento.
Q: Como o exemplo com sorvete, chocolate e chiclete ajuda a entender a formação de tokens?
O exemplo permite observar partes que se repetem em palavras diferentes e acompanhar como elas são agrupadas. A frase inclui sorvete, chocolate, chiclete e a forma tiquete, escolhida na demonstração para acrescentar uma ocorrência relevante à contagem. Após separar os caracteres, a aula mostra o agrupamento de te, depois a formação de ete e também a união de ch. Esses passos evidenciam que os tokens surgem a partir das unidades e de suas repetições no exemplo. Quando as frequências empatam, a estratégia apresentada é unir o primeiro par encontrado.
Summary & Key Takeaways
-
A tokenização faz a ligação entre texto e processamento numérico. Tokens podem representar palavras, partes de palavras ou caracteres, por isso contar palavras não equivale necessariamente a contar tokens.
-
A demonstração do BPE separa palavras em caracteres, conta pares adjacentes e une o par mais frequente. A contagem é refeita após cada união, permitindo combinar unidades que já foram agrupadas.
-
A aula relaciona tokens, embeddings e completação. Tokens fundamentam a construção dos embeddings, enquanto a completação utiliza os tokens de entrada para fazer previsões dos próximos tokens.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚

Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator