Como importar arquivos CSV com Pandas no Jupyter
TL;DR
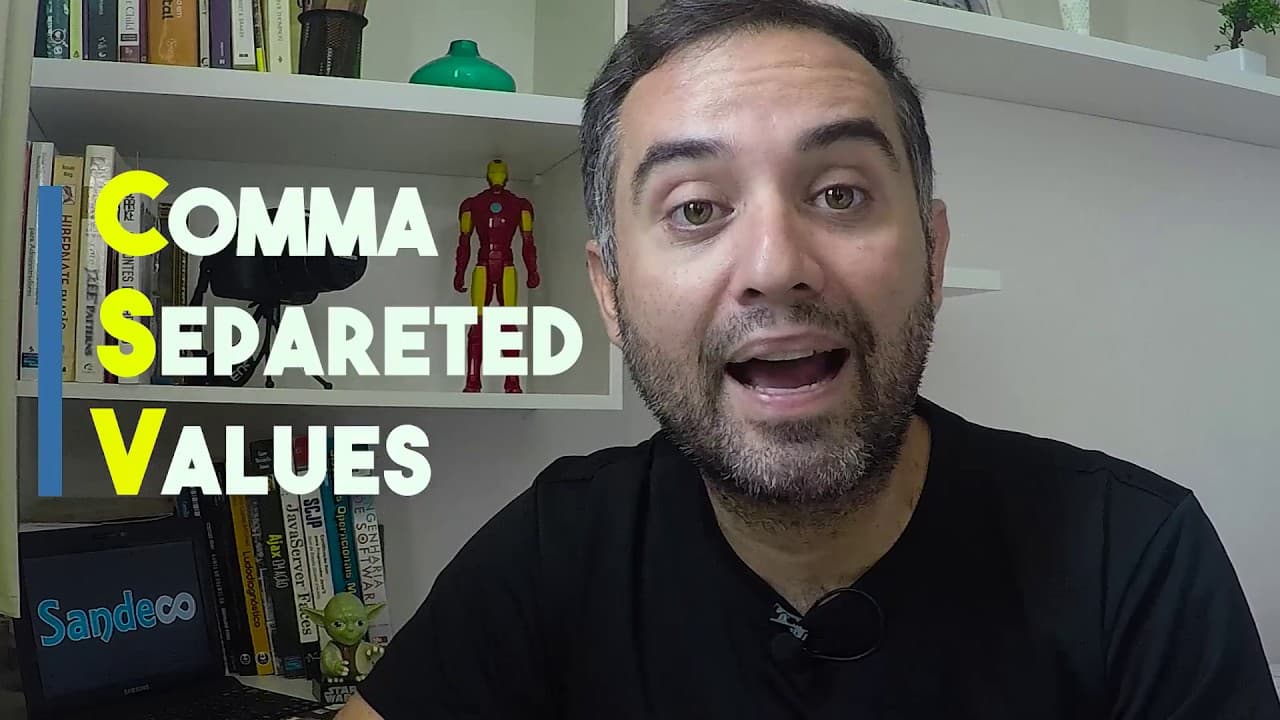
Para carregar uma tabela CSV no Pandas, importe a biblioteca, execute read_csv com o nome do arquivo e exiba a variável que recebeu os dados. O mesmo procedimento permite ler tabelas exportadas de planilhas, MySQL e PostgreSQL. Na exportação demonstrada, os campos são separados por vírgulas e os nomes das colunas aparecem na primeira linha.
Transcript
[Música] bom dia boa tarde boa luta você se vê agora assistindo mais um vídeo do canal são deco hoje eu vou falar como que a gente pode manipular o arquivo csv em que é um arquivo csv que você pode manipular o fã da cet legal o arquivo csv um tipo específico e melhorado do arquivo de texto que é usado antigamente nos meios frentes na ocupação antig... Read More
Key Insights
- CSV representa tabelas em texto, separando os campos por vírgulas e os registros por quebras de linha.
- O cabeçalho usado na demonstração ocupa a primeira linha e contém os nomes dos campos da tabela.
- A tabela de exemplo contém informações sobre flores e aparece na planilha e nos bancos de dados.
- O método read_csv do Pandas carrega os arquivos exportados e permite exibir os dados no notebook.
- A tecla Tab no Jupyter completa métodos do Pandas e também apresenta opções de nomes de arquivos.
- Shift+Enter executa as células usadas para importar a biblioteca, carregar o CSV e mostrar a tabela.
- As exportações de MySQL e PostgreSQL incluem os nomes das colunas na primeira linha do arquivo.
- Campos CSV com vírgulas, quebras de linha ou aspas devem ser envolvidos em aspas, segundo a descrição.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: O que é um arquivo CSV e como seus dados são organizados?
CSV é um formato de texto que armazena dados tabulares usando valores separados por vírgulas. Na estrutura apresentada, a primeira linha contém os nomes dos campos, formando o cabeçalho da tabela. As linhas seguintes contêm os registros, com cada valor separado por vírgula e cada registro encerrado por uma quebra de linha. A descrição também informa que campos contendo caracteres especiais, como vírgulas, quebras de linha ou aspas, devem ser envolvidos em aspas. A demonstração utiliza essa organização para compartilhar e carregar uma tabela com informações sobre flores.
Q: Como importar um arquivo CSV no Pandas usando o Jupyter?
O procedimento demonstrado começa com a importação da biblioteca Pandas em uma célula do Jupyter. Em seguida, uma variável recebe o resultado da chamada ao método read_csv, informando entre aspas o nome do arquivo que será carregado. O CSV utilizado está na mesma pasta do notebook, e o apresentador usa a tecla Tab para localizar seu nome. Depois de executar a célula com Shift+Enter, ele escreve o nome da variável em outra célula e executa novamente. O Jupyter então apresenta os dados importados em forma de tabela.
Q: Como exportar uma planilha para CSV antes de carregá-la no Pandas?
A demonstração abre uma planilha com informações sobre flores e utiliza a opção Salvar como para gerar um arquivo CSV. Na configuração da exportação, a vírgula é escolhida como delimitador de campo e as aspas como delimitador de texto. A tabela apresentada contém os nomes dos campos na primeira linha e os dados das flores nas linhas seguintes. Depois de salvar o arquivo, o apresentador retorna ao Jupyter e usa o método read_csv do Pandas para carregá-lo. Por fim, exibe a variável que recebeu o resultado para visualizar a tabela importada.
Q: Como exportar uma tabela do MySQL para CSV e abrir os dados no Pandas?
Na interface de administração do MySQL apresentada, o procedimento começa selecionando a tabela com os dados das flores e acessando a opção de exportação. O formato escolhido é CSV. A demonstração personaliza a exportação para incluir os nomes das colunas na primeira linha e manter os campos separados por vírgulas. Depois de executar a exportação e salvar o arquivo, o apresentador volta ao notebook Jupyter. Uma nova variável recebe o resultado de read_csv com o nome do CSV exportado. A execução seguinte exibe essa variável e mostra os dados da tabela.
Q: Como exportar os resultados de uma consulta PostgreSQL para um arquivo CSV?
A demonstração no PostgreSQL começa com uma consulta SQL que seleciona os dados da tabela de flores. Após visualizar o resultado, o apresentador utiliza a opção da interface que executa a consulta e escreve os dados em um arquivo. Na janela de exportação, mantém a vírgula como separador de colunas e as aspas como caractere de envolvimento dos valores. Também marca a opção de incluir os nomes das colunas. Em seguida, escolhe o local de gravação, informa um nome com extensão .csv e confirma a exportação. O arquivo resultante é carregado no Pandas com read_csv.
Q: Como usar Tab e Shift+Enter para facilitar a leitura de CSV no Jupyter?
A tecla Tab é usada na demonstração para completar comandos e localizar arquivos no Jupyter. Depois de escrever o nome usado para acessar o Pandas e um ponto, o apresentador pressiona Tab para visualizar os métodos disponíveis e selecionar read_csv. Dentro das aspas destinadas ao nome do arquivo, Tab também apresenta opções de arquivos da pasta. Já Shift+Enter executa as células do notebook. Esse atalho aparece na importação da biblioteca, na leitura do CSV e na exibição da variável com os dados. Os dois recursos acompanham as etapas de carregamento da tabela.
Q: Por que o CSV é usado para compartilhar dados entre planilhas, bancos e Pandas?
O CSV é apresentado como um formato simples, leve e amplamente utilizado para compartilhar dados. A transcrição destaca seu uso em diferentes plataformas e dispositivos, além da possibilidade de leitura por diferentes linguagens de programação. A demonstração mostra essa aplicação usando a mesma tabela de flores em uma planilha, no MySQL e no PostgreSQL. Cada origem permite exportar os dados para CSV, e os arquivos resultantes são abertos com o mesmo método do Pandas. Assim, o exemplo mostra um formato comum para levar dados dessas diferentes origens ao notebook.
Q: Qual é o papel do cabeçalho, das vírgulas e das aspas em um arquivo CSV?
No exemplo apresentado, o cabeçalho identifica os campos da tabela e fica na primeira linha do arquivo. As vírgulas separam os valores de cada registro, enquanto as quebras de linha separam os registros. As aspas aparecem nas configurações de exportação como delimitadores de texto ou caracteres de envolvimento dos valores. A descrição esclarece que campos com vírgulas, quebras de linha ou aspas devem ser envolvidos em aspas. Nas exportações dos bancos de dados, o apresentador também seleciona a inclusão dos nomes das colunas, reproduzindo a organização que havia mostrado na planilha.
Summary & Key Takeaways
-
CSV armazena dados tabulares em texto, com campos separados por vírgulas e registros por quebras de linha. O exemplo usa um cabeçalho com os nomes das colunas e uma tabela com informações sobre flores.
-
No Jupyter, a demonstração importa Pandas, utiliza read_csv para carregar um arquivo e exibe a variável resultante. Tab auxilia a completar métodos e nomes de arquivos; Shift+Enter executa as células.
-
A mesma tabela é exportada de uma planilha, do MySQL e do PostgreSQL. As exportações incluem os nomes das colunas e usam vírgulas como separadores, permitindo carregar os arquivos resultantes no Pandas.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚

Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator