Como classificar dados com KNN e distâncias
TL;DR
O KNN classifica um novo objeto calculando suas distâncias aos exemplos conhecidos, selecionando os k vizinhos mais próximos e atribuindo a classe majoritária entre eles. O método também pode realizar regressão pela média dos valores dos vizinhos. A escolha de k e da métrica de distância deve ser testada empiricamente, comparando a acurácia obtida.
Transcript
fala pessoal bom dia boa tarde boa noite quando você tiver agora assistindo essa revisão aqui com o professor sandro é cocô a kaká a grande abraço pra vocês saudade de vocês bom hoje nós vamos ver aqui aquela revisão que o momento eu tinha prometido para vocês né nós vamos fazer uma revisão eu vou fazer a revisão separada serão dois vídeos sobre a ... Read More
Key Insights
- O KNN usa a proximidade entre objetos descritos por características para realizar predições.
- Dados semelhantes tendem a se concentrar na mesma região do espaço, conforme a hipótese do KNN.
- A classificação atribui ao novo objeto a classe majoritária entre os k vizinhos mais próximos.
- A regressão com KNN utiliza a média dos valores dos objetos selecionados como vizinhos próximos.
- O parâmetro k define quantos objetos próximos participam da decisão sobre a classe do novo dado.
- Um ponto atípico pode influenciar a classificação quando apenas o vizinho mais próximo é considerado.
- A distância euclidiana usa a raiz quadrada da soma das diferenças quadráticas entre características.
- A distância Manhattan soma os módulos das diferenças entre características correspondentes dos objetos.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: Como o KNN classifica um objeto desconhecido?
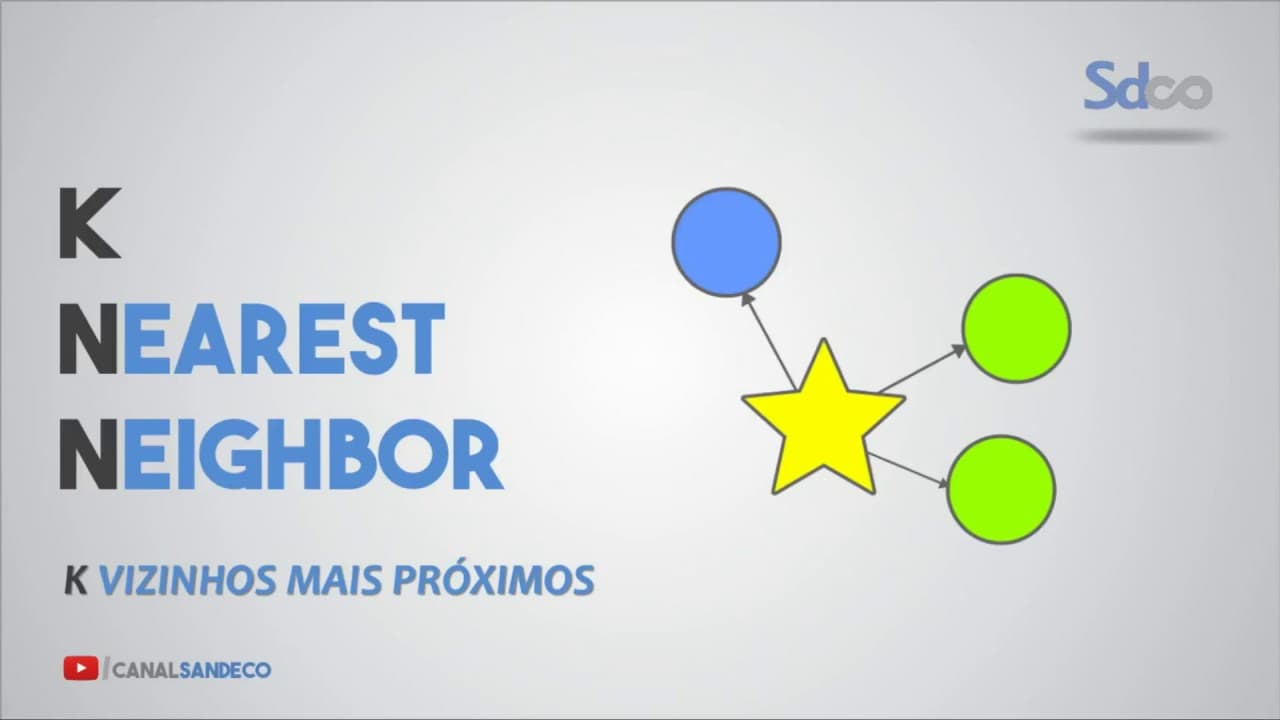
O KNN classifica um objeto desconhecido a partir da proximidade dele com objetos cujas classes já são conhecidas. Primeiro, calcula a distância entre o novo objeto e os exemplos disponíveis, usando suas características. Depois, ordena essas distâncias da menor para a maior e seleciona a quantidade de vizinhos definida pelo parâmetro k. A classe majoritária nesse conjunto é atribuída ao novo objeto. Na ilustração da revisão, uma estrela representa o objeto desconhecido, enquanto círculos e quadrados representam as classes conhecidas usadas para decidir sua classificação.
Q: Qual é a hipótese sobre os dados que fundamenta o KNN?
A hipótese apresentada é que dados semelhantes tendem a estar concentrados na mesma região do espaço. Essa semelhança é observada nas características que descrevem cada objeto e permite usar a proximidade como base para uma predição. Na representação com círculos e quadrados, objetos de uma mesma classe tendem a se agrupar em determinadas áreas. Quando chega um objeto desconhecido, sua posição em relação aos exemplos conhecidos ajuda a decidir a classe. O KNN transforma essa intuição visual em uma classificação baseada no cálculo e na ordenação das distâncias.
Q: O que significa o parâmetro k no KNN?
O parâmetro k indica quantos vizinhos mais próximos serão considerados para decidir a classe de um novo objeto. Após calcular e ordenar as distâncias, o método faz um corte na lista de exemplos para selecionar essa quantidade. Quando k é igual a 1, a decisão depende apenas do objeto mais próximo. No exemplo apresentado, esse objeto é um círculo, mas considerar k igual a 3 inclui também dois quadrados e muda a classe majoritária. Assim, alterar k modifica o conjunto de objetos que participa da votação e pode mudar a classificação.
Q: Por que usar apenas o vizinho mais próximo pode prejudicar a classificação?
Usar apenas o vizinho mais próximo pode tornar a decisão dependente de um ponto atípico. No exemplo da revisão, o objeto desconhecido está próximo de uma região com quadrados, mas o exemplo individual mais próximo é um círculo. Com k igual a 1, o KNN atribui a classe círculo à estrela, seguindo exclusivamente esse vizinho. Ao considerar k igual a 3, entram na decisão um círculo e dois quadrados, fazendo a classe quadrado prevalecer. A demonstração mostra por que a escolha de k precisa ser avaliada empiricamente, comparando a acurácia.
Q: Como escolher o valor de k para uma classificação com KNN?
A recomendação da revisão é realizar testes empíricos com diferentes valores de k e comparar a acurácia de cada configuração. O exemplo mostra que a decisão pode mudar quando se considera apenas o vizinho mais próximo ou um conjunto maior de vizinhos. O professor também sugere valores pequenos e ímpares, relacionando essa preferência à possibilidade de empate na votação entre as classes ilustradas. Entretanto, a orientação central é testar qual valor funciona melhor nos dados usados, em vez de escolher k apenas pela aparência da distribuição dos objetos no gráfico.
Q: Como o KNN pode ser usado para regressão?
O KNN pode ser usado para regressão aproveitando a mesma ideia de proximidade empregada na classificação. A revisão descreve que, para regressão, a predição é feita pela média dos valores dos objetos mais próximos. O procedimento continua dependendo da identificação dos vizinhos do novo objeto por meio das distâncias entre suas características. A diferença está na forma de obter a resposta: a classificação escolhe uma classe majoritária, enquanto a regressão calcula uma média dos valores dos vizinhos. O professor apresenta essa adaptação como uma utilização do método que não exige grandes alterações.
Q: Como calcular as distâncias euclidiana e Manhattan no KNN?
A distância euclidiana é apresentada como a raiz quadrada da soma dos quadrados das diferenças entre características correspondentes dos objetos. Na representação com os eixos x e y, o cálculo compara as coordenadas dos pontos. A explicação também generaliza a operação para outras características, como medidas de sépalas e pétalas. Já a distância Manhattan soma os módulos das diferenças entre as características correspondentes. Para explicar essa segunda métrica, a revisão usa a analogia de um deslocamento pelas ruas de uma grade, em vez de um percurso direto entre os pontos.
Q: Como a visualização das flores Iris ajuda a entender o KNN?
A visualização das flores Iris ajuda a observar como objetos de classes diferentes se distribuem quando suas características são combinadas em gráficos de dispersão. A revisão usa medidas de sépalas e pétalas para mostrar regiões ocupadas pelas classes setosa, versicolor e virginica. A setosa aparece mais isolada em relação às outras, enquanto versicolor e virginica ficam próximas em algumas combinações de características. Essa observação ilustra a hipótese de que objetos semelhantes tendem a se concentrar em regiões próximas e mostra por que a distância pode ser usada para classificar um novo exemplo.
Summary & Key Takeaways
-
O KNN parte da hipótese de que objetos com características semelhantes tendem a ocupar regiões próximas. Para classificar um novo objeto, calcula distâncias e considera a classe majoritária dos vizinhos.
-
O parâmetro k determina quantos vizinhos entram na decisão. O exemplo mostra que o vizinho mais próximo pode ser um ponto atípico, enquanto considerar mais vizinhos pode alterar a classificação atribuída.
-
As distâncias euclidiana e Manhattan medem a proximidade entre características correspondentes dos objetos. A revisão recomenda testar a métrica e diferentes valores de k para comparar a acurácia.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚


Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator