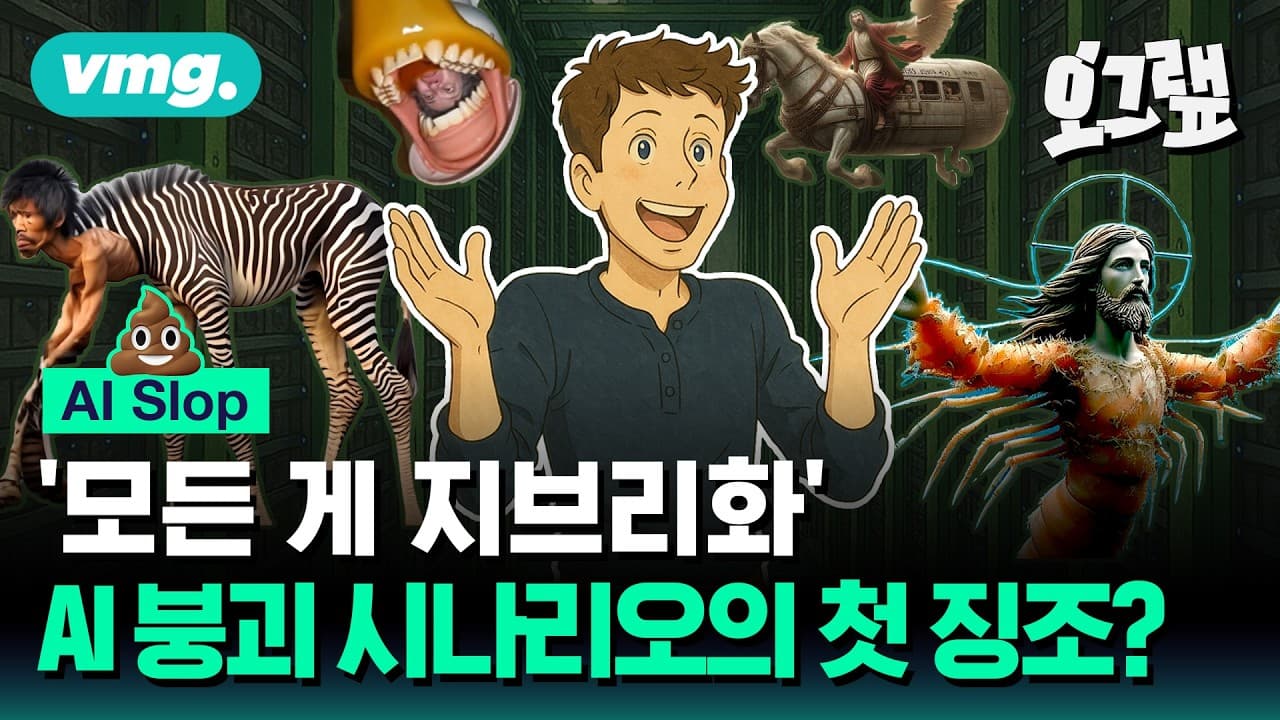
AI 생성물이 인터넷과 AI 모델의 신뢰도를 어떻게 무너뜨리나?
TL;DR
AI 생성물이 웹에 무분별하게 축적되면 검색과 플랫폼의 품질이 낮아지고, 검증되지 않은 합성 데이터를 다시 학습한 AI 모델은 다양성과 정확성을 잃을 수 있다. 이를 줄이려면 기업의 식별 기술 개발과 정부 규제를 병행하고, AI 생성물에 명확한 표시를 남겨 인간이 만든 자료와 구분할 수 있어야 한다.
Transcript
[음악] 안녕하세요 데이터를 만지고 다루는 아네 기자입니다 다섯 가지 그래프로 설명하는 오그랩 오늘 다뤄볼 주제는 인터넷을 가득 채우고 있는 AI 생성물입니다 이미 많은 분들이 온라인상에서 AI가 만들어 낸 그림이나 영상들을 보셨을 거예요 예전보다 AI 모델의 편의성도 크게 올라서 직접 만들어 보신 분들도 많으실 것 같습니다 그런데 이렇게 넘쳐나는 AI 생성물들 많아도 너무 많아서 한편으로는 우려스럽기도 합니다 어떤게 AI가 만든 합성 데이터이고 어떤게 인간이 만든 데이터인지 구분이 되지 않는 상황이 이어져도 괜찮은 건지 걱정도 되고요 오늘 준비한 다섯 가지 그래프를 통해 AI 생성물의 우려 지점을 살펴보도록 하겠습니다... Read More
Key Insights
- 2022년부터 2023년까지 AI가 생성한 이미지는 에브리픽셀 추정으로 154억 7천만 개이며, 하루 평균 약 3,400만 개였다.
- AI 슬롭은 생성형 AI로 대량 생산된 쓸모없는 콘텐츠를 뜻하며, 검색 결과와 SNS의 품질 및 이용 경험을 떨어뜨린다.
- AI 이미지의 품질이 높아질수록 사람의 창작물과 구분하기 어려워져, 출처와 신뢰성을 판단하는 문제도 더 커진다.
- 바이트스파이더는 2024년 전체 AI 봇 트래픽의 38.6%를 차지했으며, 바이트댄스의 언어 모델 학습 자료 수집에 쓰이는 것으로 알려졌다.
- 프린스턴대 연구진이 조사한 영문 위키피디아 신규 문서 2,909개 중 최대 5.36%가 AI 생성 자료를 포함한 것으로 분류됐다.
- AI 작성으로 분류된 위키피디아 문서는 전체 문서보다 문장당 각주와 단어당 외부 링크가 적어 출처 검증과 연결성이 떨어졌다.
- 이전 세대가 생성한 데이터만 반복 학습한 실험에서는 숫자와 얼굴, 문장이 세대를 거치며 다양성과 원래 형태를 잃었다.
- AI 생성물의 재학습 위험을 줄이려면 기업의 식별 기술, 정부 규제, 생성물 표시 체계를 병행해 합성 데이터의 유입을 관리해야 한다.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: AI 생성물이 인터넷의 신뢰도를 왜 떨어뜨리나요?
AI 생성물은 출처나 생성 여부가 표시되지 않은 채 검색 결과, SNS, 위키피디아에 섞일 수 있기 때문이다. 모델의 환각이 남아 있는 상황에서 검증되지 않은 글과 이미지가 사실처럼 유통되면 이용자는 인간이 만들고 검증한 정보와 합성 정보를 구분하기 어려워진다.
Q: AI 슬롭이란 무엇인가요?
AI 슬롭은 생성형 AI가 만들어 낸 쓸모없는 콘텐츠를 가리키는 표현이다. 음식물 찌꺼기나 오물을 뜻하는 슬롭에서 나온 말로, 대량 생산된 이미지와 영상, 글이 검색과 SNS를 채우면서 유용한 결과를 찾기 어렵게 만드는 현상을 설명한다.
Q: AI 이미지가 얼마나 빠르게 늘어났나요?
에브리픽셀의 추정에 따르면 2022년부터 2023년까지 AI가 생성한 이미지는 모두 154억 7천만 개였다. 이는 하루 평균 약 3,400만 개에 해당하며, 대부분은 오픈 소스인 스테이블 디퓨전을 기반으로 만들어진 것으로 제시됐다.
Q: AI 크롤러는 웹사이트에 어떤 피해를 줄 수 있나요?
AI 크롤러는 과도한 요청과 대규모 데이터 수집으로 웹사이트 운영에 부담을 줄 수 있다. 소개된 사례에서는 오픈AI의 크롤링 봇이 데이터를 수집하는 과정에서 2D 이미지 업체의 사이트가 다운됐고, 하루에 10TB 규모의 데이터를 가져간 사례도 언급됐다.
Q: 위키피디아에는 AI가 만든 글이 얼마나 포함됐나요?
프린스턴대 연구진의 분류에서는 2024년 8월 생성된 영문 위키피디아 문서 2,909개 가운데 최대 5.36%가 AI 생성 자료를 포함한 것으로 나타났다. 두 프로그램은 각각 156개와 96개를 AI 작성 문서로 분류했으므로, 이 수치는 탐지 결과에 따른 추정치다.
Q: AI가 작성한 위키피디아 문서는 어떤 특징을 보였나요?
AI 작성으로 분류된 문서는 전체 문서보다 각주와 외부 링크가 적었다. 제시된 비교에서 문장당 각주는 전체 문서 0.97에서 AI 문서 0.67로 낮아졌고, 단어당 외부 링크 비율도 1.77과 0.38로 큰 차이를 보였다.
Q: AI 자가포식과 모델 붕괴는 무엇인가요?
AI 자가포식은 AI가 생성한 데이터를 다시 AI 학습에 사용하는 현상이며, 이것이 반복되면 모델 붕괴로 이어질 수 있다. 이전 세대가 만든 자료만 다음 세대에 학습시킨 실험에서는 숫자 이미지와 얼굴의 다양성이 사라지고 문장도 알아보기 어려운 형태로 변했다.
Q: 합성 데이터를 AI 학습에서 완전히 제외해야 하나요?
제시된 설명에 따르면 합성 데이터를 학습에서 완전히 배제하기는 어렵다. 고품질 데이터만 사용하는 데에는 경제적 제약이 있으므로, 모델이 만든 데이터와 다른 자료를 적절히 조합하되 웹에서 유입되는 합성 데이터의 규모와 품질을 통제하는 것이 핵심이다.
Q: AI 생성물로 인한 모델 붕괴를 어떻게 줄일 수 있나요?
AI 생성물에 명확한 표시를 남기고, 기업의 식별 기술 개발과 정부의 규제를 병행해야 한다. 현재 탐지 기술은 완벽하지 않으므로 기술만으로 해결하기보다 규제 기관과 협력해 인간 자료와 합성 자료를 구분하고 학습 데이터 유입을 관리하는 체계가 필요하다.
Q: 위키피디아는 AI 생성 콘텐츠에 어떻게 대응하고 있나요?
위키피디아 이용자들은 프로젝트 AI 클린업을 결성해 AI 생성물이 페이지에 적절하게 사용됐는지 확인하고 있다. 문제가 발견된 게시물은 삭제하거나 편집해 신뢰도를 높이며, 영상에서 제시한 3월 26일 기준 활동 유저 수는 123명이다.
Summary & Key Takeaways
-
AI 이미지 생산은 빠르게 증가했다. 에브리픽셀의 추정에 따르면 2022년부터 2023년까지 생성된 이미지는 154억 7천만 개이며, 하루 평균은 약 3,400만 개였다. 이런 콘텐츠는 검색과 SNS를 채우며 이용자의 피로를 높이고 광고 수익을 노린 AI 슬롭의 확산을 촉진한다.
-
AI 모델 학습을 위한 크롤러도 웹에 큰 부담을 준다. 클라우드플레어 자료에서 바이트댄스의 바이트스파이더는 2024년 AI 봇 트래픽의 38.6%를 차지했다. 일부 봇은 사이트 장애나 하루 10TB 규모의 데이터 수집 사례를 낳았고, 차단 조치를 어긴 사례도 보고됐다.
-
더 큰 위험은 AI가 만든 데이터를 다음 세대 AI가 반복 학습하는 자가포식이다. 이전 세대의 생성물만 학습한 실험에서는 세대가 지날수록 숫자, 얼굴, 문장의 다양성과 형태가 무너졌다. 이를 막으려면 생성물 표시, 탐지 기술, 데이터 관리와 제도적 규제를 함께 마련해야 한다.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from 비디오머그 - VIDEOMUG 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator