Como a atenção multihead separa contextos na IA
TL;DR
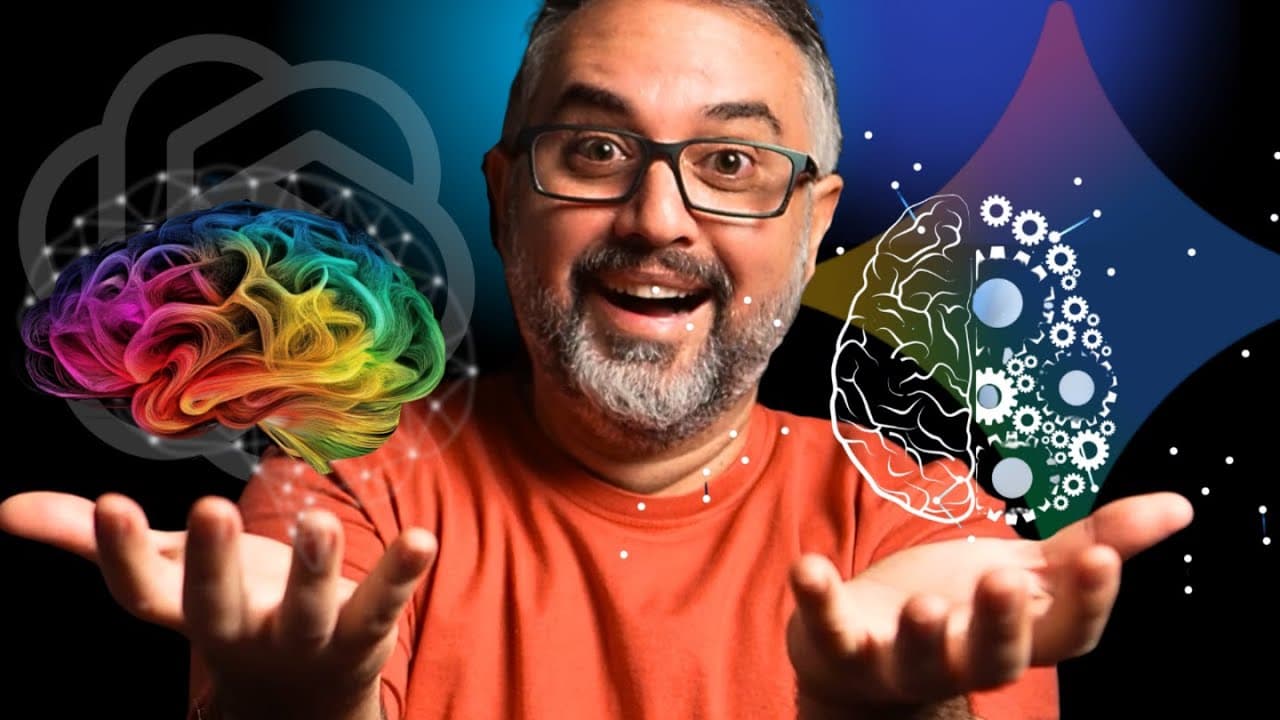
A atenção multihead cria várias projeções de uma representação vetorial para analisar uma palavra ou assunto sob perspectivas distintas. Segundo a explicação, essa separação matemática ajuda ChatGPT e Gemini a distinguir contextos, aproximar informações relevantes do prompt e produzir textos de melhor qualidade, embora aumentar o número de projeções também eleve o tempo de processamento.
Transcript
Muito bem, pessoal. Hoje eu vou falar sobre o segredo das múltiplas mentes do chat GPT e do Gemini. É uma ideia interessante como é que o chat GPT e como o Gemini tratam os dados dentro deles, né, no momento em que eles vão aprender, certo? É a ideia do multihead attention. Ele tem várias cabeças de pensamento, digamos assim. E aí vem essa frase, n... Read More
Key Insights
- Um embedding representa uma palavra como um vetor matemático dentro da arquitetura Transformer.
- Cada cabeça de atenção resulta de uma projeção aplicada ao vetor que representa a entrada.
- A demonstração usa três planos cartesianos para visualizar projeções de uma mesma palavra.
- O Transformer original é apresentado no vídeo como uma arquitetura com oito projeções.
- Mais projeções podem separar melhor assuntos, mas também aumentam o tempo de processamento.
- A projeção pode revelar grupos de dados que pareciam misturados sob uma perspectiva única.
- ChatGPT e Gemini usam o contexto do prompt para aproximar palavras e assuntos relevantes.
- A metáfora das lanternas mostra como um vetor pode gerar sombras diferentes em cada plano.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: O que é atenção multihead no Transformer?
A atenção multihead é apresentada como uma técnica interna da arquitetura Transformer usada por sistemas como ChatGPT e Gemini. Ela aplica diferentes projeções matemáticas à representação vetorial de uma palavra ou informação. Cada resultado projetado corresponde a uma cabeça de atenção, permitindo que o modelo examine o mesmo dado sob perspectivas distintas. Na explicação do vídeo, essas cabeças ajudam a separar assuntos, relacionar o contexto do prompt com as palavras relevantes e melhorar a qualidade das informações empregadas durante a geração de texto.
Q: Como um embedding representa uma palavra no modelo?
Um embedding é descrito como um vetor, representado visualmente por uma seta em um espaço cartesiano. No exemplo, a palavra “ponto” recebe essa representação vetorial dentro do Transformer. O vetor funciona como o dado de entrada que será transformado pelas projeções da atenção. Para facilitar a compreensão, a demonstração coloca o embedding em um ambiente tridimensional, embora o próprio vídeo ressalte que modelos podem trabalhar matematicamente com mais projeções do que aquelas que uma visualização em três dimensões permite mostrar.
Q: Como as projeções geram cabeças de atenção?
As cabeças de atenção surgem quando o vetor de entrada é submetido a diferentes projeções matemáticas. A demonstração compara o processo a lanternas apontadas para um vetor: cada luz produz uma sombra em um plano cartesiano diferente. Essas sombras simbolizam versões projetadas da mesma informação. No exemplo simplificado, um único vetor associado à palavra “ponto” origina três vetores menores. Cada um deles é tratado como uma cabeça de atenção, e o conjunto fornece várias perspectivas matemáticas sobre o mesmo dado de entrada.
Q: Por que o vídeo usa lanternas e sombras como metáfora?
As lanternas e sombras tornam visualmente acessível o processo de projeção de um vetor. O vetor original representa uma palavra, enquanto cada lanterna ilumina esse vetor de uma direção diferente. A sombra criada em determinado plano simboliza uma projeção usada pela atenção direcionada. Ao acender três lanternas em posições distintas, a demonstração produz três representações da mesma entrada. A metáfora permite visualizar, em um espaço tridimensional, como diferentes cabeças podem extrair perspectivas variadas de uma única informação antes da geração do texto.
Q: Como a atenção multihead ajuda a separar assuntos?
A explicação compara assuntos a grupos de dados que parecem sobrepostos quando observados de uma única posição. Ao projetar ou girar esses dados, os grupos tornam-se visualmente separados. Aplicada às palavras de um prompt, essa ideia significa que diferentes projeções ajudam o modelo a distinguir assuntos que poderiam parecer misturados em uma representação única. O vídeo afirma que essa separação permite aproximar do prompt as informações relacionadas ao assunto solicitado, reduzindo confusões entre contextos e favorecendo uma saída textual considerada de melhor qualidade.
Q: Quantas projeções são mostradas na explicação?
A demonstração visual mostra três projeções porque utiliza um espaço cartesiano tridimensional. O vetor da palavra “ponto” é projetado em diferentes planos, gerando três representações que podem ser observadas como sombras. O vídeo também informa que o Transformer original trabalhou com oito projeções. Como oito perspectivas não podem ser exibidas diretamente no exemplo tridimensional, a explicação limita-se a três para fins didáticos. Ainda assim, ela afirma que outras quantidades de projeções são matematicamente possíveis, inclusive valores superiores a oito.
Q: Qual é o custo de aumentar o número de projeções?
Segundo o vídeo, aumentar a quantidade de projeções pode tornar os dados e assuntos mais separados, oferecendo mais perspectivas sobre cada representação de entrada. Entretanto, essa ampliação também exige mais tempo para processar a informação. Por esse motivo, existe um limite prático para a quantidade utilizada. A explicação apresenta, portanto, uma relação entre separação e custo: mais cabeças podem ajudar a distinguir contextos, mas seu aumento não é gratuito, pois torna o processamento mais demorado durante as transformações realizadas pelo modelo.
Q: Como o contexto do prompt participa desse mecanismo?
O contexto do prompt orienta quais assuntos e palavras devem receber atenção durante a geração. Na explicação, cada grupo de dados representa um assunto e cada elemento desse grupo pode ser entendido como uma palavra. O modelo precisa aproximar do prompt o assunto pertinente e evitar que informações de grupos distintos se confundam. As projeções da atenção contribuem para essa organização ao oferecer representações separadas dos dados. Assim, ChatGPT e Gemini usam tanto o contexto fornecido quanto as projeções para selecionar informações relacionadas à solicitação.
Summary & Key Takeaways
-
Cada palavra é representada no Transformer por um embedding, isto é, um vetor matemático. O exemplo usa a palavra “ponto” em um espaço tridimensional para tornar visível essa representação abstrata.
-
A atenção direcionada projeta o vetor de entrada em planos diferentes. Cada projeção produz uma nova representação da mesma palavra, chamada no vídeo de cabeça de atenção.
-
As múltiplas projeções ajudam a separar assuntos que poderiam parecer misturados em uma única perspectiva. O benefício apresentado é uma interpretação mais clara do contexto, com maior custo de processamento.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚


Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator