Como a inteligência artificial classifica dados?
TL;DR
A inteligência artificial aprende identificando agrupamentos e proximidades entre exemplos já classificados, depois usa esses padrões para estimar a classe de novos dados. No conjunto Iris, medidas de sépalas e pétalas separam três tipos de flores, embora a sobreposição entre versicolor e virginica gere incerteza e exija classificações probabilísticas.
Transcript
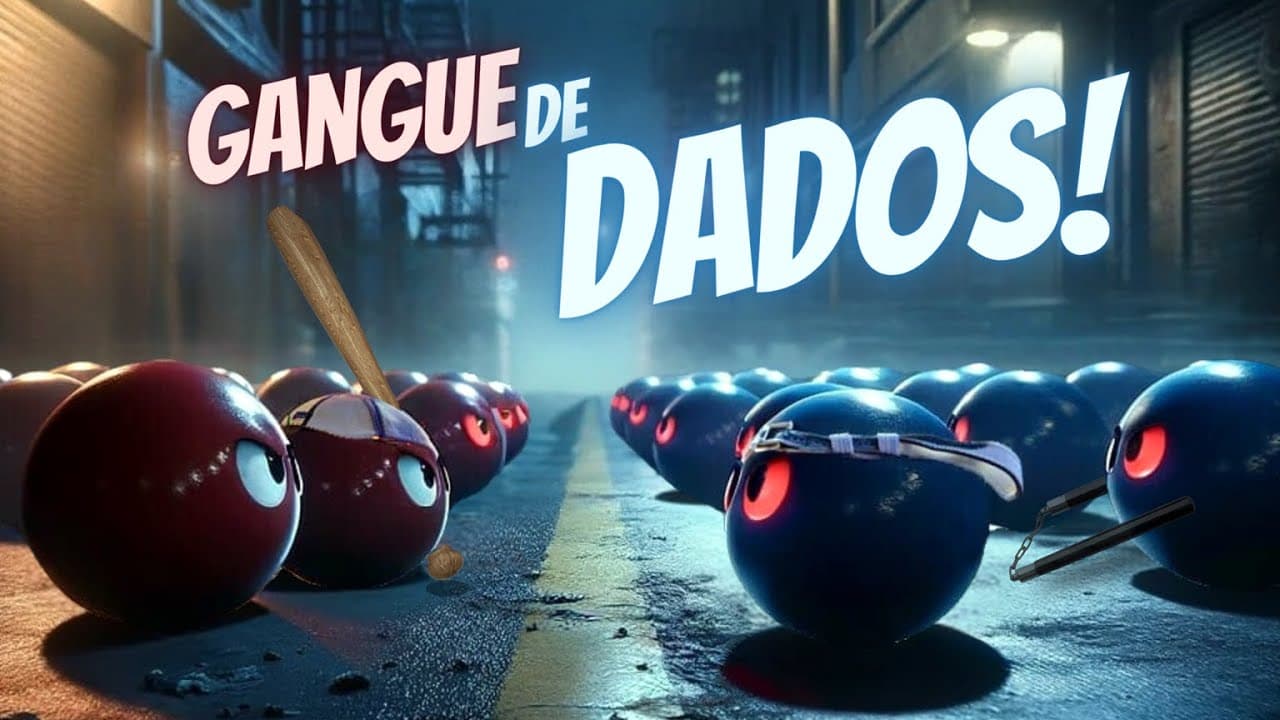
Olá tudo bem Hoje eu vou mostrar um exemplo visual né de o pessoal sempre pergunta para mim como é que a inteligência artificial aprende E aí o exemplo visual vai ser exatamente sobre isso aqui que você tá vendo né a gang de dados né como é que os dados brigam brigam para disputar sobre a classificação de novos dados então assim eu quero mostrar aq... Read More
Key Insights
- O conjunto Iris contém 150 flores, divididas igualmente entre três classes com 50 exemplos cada.
- As medidas de largura e altura das sépalas e pétalas funcionam como características para a classificação.
- A Iris setosa forma um agrupamento visualmente mais separado dos grupos versicolor e virginica.
- Um novo dado tende a receber a classe dos exemplos conhecidos que estão mais próximos de sua posição.
- A sobreposição entre versicolor e virginica cria regiões de conflito e aumenta a incerteza da previsão.
- Uma previsão pode indicar 90% de probabilidade quando uma classe predomina, mas existe outra classe próxima.
- Uma visualização em duas dimensões pode misturar classes que ficam separadas quando observadas em 3D.
- Redes neurais profundas tendem a lidar melhor com espaços de dados e configurações mais complexas.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: Como uma inteligência artificial aprende a classificar novos dados?
Uma inteligência artificial aprende observando exemplos já classificados e identificando como suas características se distribuem. No exemplo apresentado, cada flor possui medidas de largura e altura da sépala e da pétala, além do rótulo setosa, versicolor ou virginica. Ao visualizar esses registros, aparecem agrupamentos de flores semelhantes. Quando uma nova flor é fornecida, o sistema compara sua posição com esses grupos e estima a classe mais provável conforme a proximidade. Regiões bem separadas permitem maior certeza, enquanto áreas de sobreposição produzem incerteza.
Q: O que é o problema Iris usado para explicar aprendizagem de máquina?
O problema Iris é apresentado como um exemplo clássico e introdutório de inteligência artificial. A base possui 150 flores, distribuídas em 50 exemplares de setosa, 50 de versicolor e 50 de virginica. Para cada flor, foram registradas medidas relacionadas à largura e à altura da sépala e da pétala. O objetivo é usar essas informações para descobrir a classe de uma nova flor. Assim, a inteligência artificial funciona como um especialista que recebe as medidas, compara o novo caso com os exemplos armazenados e produz uma classificação.
Q: Quais características das flores são usadas para fazer a classificação?
A classificação utiliza medidas da sépala e da pétala de cada flor. O processo descrito registra a largura e a altura dessas partes, criando um conjunto de características numéricas para cada exemplar. Essas informações são armazenadas em uma base de dados junto com a classe correta, que pode ser setosa, versicolor ou virginica. Ao analisar a distribuição das medidas, o algoritmo reconhece padrões associados a cada tipo. Uma nova flor pode então ser posicionada nesse espaço de dados e comparada com os agrupamentos formados pelos exemplos conhecidos.
Q: Por que a Iris setosa é mais fácil de classificar nesse exemplo?
A Iris setosa é mais fácil de classificar porque suas medidas formam um agrupamento visualmente separado dos grupos versicolor e virginica no gráfico de dispersão mostrado. Essa distância reduz o conflito entre classes: quando uma nova flor aparece perto dos pontos de setosa e longe dos demais, a classificação pode alcançar um grau de certeza maior. O exemplo menciona uma região na qual seria possível considerar a flor setosa com 100% de certeza. Já versicolor e virginica possuem medidas mais semelhantes e aparecem parcialmente misturadas.
Q: Por que há incerteza entre as classes versicolor e virginica?
A incerteza surge porque os dados de versicolor e virginica apresentam medidas semelhantes e ocupam regiões próximas ou sobrepostas no gráfico. Em determinado ponto, uma nova flor pode estar perto de um exemplar virginica, mas cercada por uma maioria de exemplares versicolor. Nesse caso, o sistema considera a distribuição dos vizinhos e pode atribuir uma probabilidade maior à classe predominante, como 90% para versicolor no exemplo apresentado. A presença próxima da outra classe impede uma certeza completa e revela uma região de conflito entre os agrupamentos.
Q: Como o gráfico de dispersão ajuda a entender a classificação?
O gráfico de dispersão transforma as medidas das flores em posições visuais, permitindo observar onde os exemplos de cada classe se concentram. Os pontos de setosa aparecem em uma região distinta, enquanto versicolor e virginica ficam mais próximas e parcialmente misturadas. Essa representação torna visível a lógica de proximidade usada na explicação: uma nova flor colocada perto de determinado grupo tende a receber o rótulo desse grupo. O gráfico também evidencia áreas ambíguas, nas quais diferentes classes coexistem e a previsão precisa expressar algum grau de incerteza.
Q: Por que visualizar os dados em mais dimensões pode melhorar a separação?
Uma visualização em duas dimensões pode fazer pontos de classes diferentes parecerem misturados, mesmo quando existe uma separação em outra dimensão. O exemplo propõe imaginar a rotação dos dados em 3D: apesar da sobreposição na perspectiva inicial, os pontos azuis poderiam estar mais à esquerda e os vermelhos mais à direita. Essa mudança de perspectiva revelaria uma divisão que não estava clara no plano. A explicação mostra que espaços de dados complexos podem exigir mais dimensões para expor os padrões que ajudam o algoritmo a distinguir corretamente as classes.
Q: Qual é a relação entre proximidade de dados, redes neurais e ChatGPT?
A explicação relaciona diferentes modelos de inteligência artificial pela busca de configurações de proximidade nos dados. No exemplo das flores, a proximidade entre medidas ajuda a decidir a classe de uma nova observação. Em ambientes mais complexos, redes neurais profundas tendem a lidar melhor com distribuições nas quais os grupos não ficam facilmente separados. O ChatGPT também é citado por trabalhar com embeddings de texto e com a proximidade envolvida na produção da próxima palavra. Assim, a ideia visual dos agrupamentos serve como introdução comum a sistemas simples e profundos.
Summary & Key Takeaways
-
O conjunto Iris reúne 150 flores, sendo 50 setosa, 50 versicolor e 50 virginica, descritas por medidas de largura e altura de sépalas e pétalas para permitir a aprendizagem de padrões.
-
No gráfico de dispersão, exemplos da mesma classe formam agrupamentos. Uma nova flor pode ser classificada pela proximidade com esses grupos, como se os dados semelhantes pertencessem à mesma gangue.
-
Regiões com classes sobrepostas produzem incerteza, enquanto agrupamentos isolados favorecem maior certeza. Em estruturas mais complexas, outras dimensões podem revelar separações invisíveis em uma visão 2D.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚


Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator