Como o KNN classifica pelos vizinhos próximos?
TL;DR
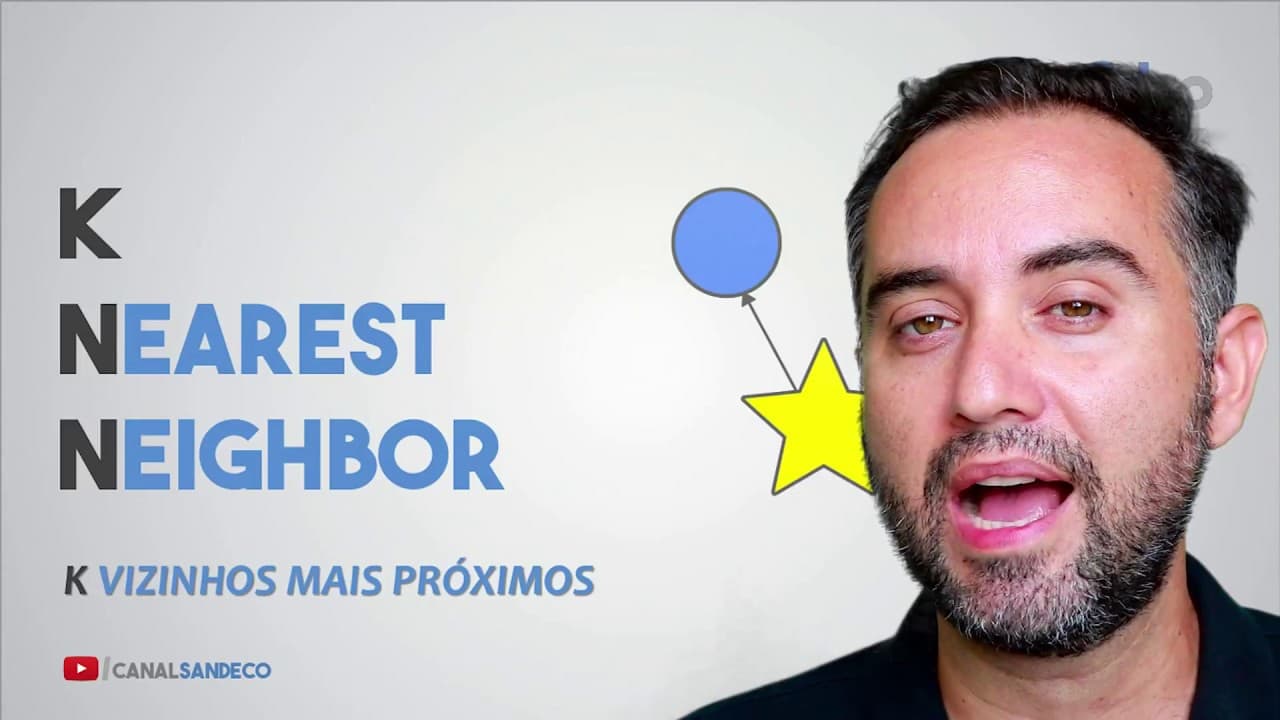
O KNN classifica um novo exemplo calculando sua distância até os dados conhecidos, selecionando os k vizinhos mais próximos e considerando os rótulos predominantes. O método parte da hipótese de que dados similares se concentram na mesma região, pode ser aplicado à classificação e à regressão e exige cuidado na escolha de k para reduzir a possibilidade de empates.
Transcript
o dia boa tarde boa noite onde você estiver agora assistindo mais um vídeo que a nossa neco único mês anderson macedo o professor e pesquisador na área de inteligência artificial e bebidas ice [Música] eu vejo que hoje é meio que uma continuação do vídeo anterior quando eu mostrei o uso de uma inteligência artificial que é capaz de prever o tipo um... Read More
Key Insights
- O KNN pressupõe que dados semelhantes tendem a se concentrar na mesma região do espaço de dispersão.
- A dispersão das medidas das flores Iris revela agrupamentos associados às diferentes classes observadas.
- O algoritmo calcula a distância entre o novo objeto e todos os exemplos conhecidos da base de dados.
- A distância euclidiana soma diferenças quadráticas das características e extrai a raiz quadrada.
- Os exemplos calculados são ordenados da menor para a maior distância antes da escolha dos vizinhos.
- A classe do novo objeto é definida pelos rótulos que predominam entre os k vizinhos selecionados.
- Um valor par de k pode produzir empate, enquanto um valor ímpar ajuda a evitar esse resultado.
- O KNN exige pouco tempo de treinamento, mas pode ter alto custo para classificar um novo exemplo.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: O que é o algoritmo KNN e qual hipótese orienta seu funcionamento?
O KNN, chamado de k vizinhos mais próximos, é um método de aprendizado de máquina baseado em distâncias. Sua hipótese central é que dados similares tendem a ficar concentrados na mesma região do espaço de dispersão. Assim, objetos relacionados ao mesmo conceito costumam aparecer próximos entre si. Para classificar um exemplo ainda desconhecido, o método procura exemplos conhecidos que estejam mais perto dele e usa os rótulos desses vizinhos como referência. A descrição também o caracteriza como um Lazy Learner, pois o aprendizado ocorre quando uma nova classificação é solicitada.
Q: Como o KNN classifica um novo exemplo passo a passo?
Primeiro, o KNN calcula a distância entre o novo exemplo e os demais exemplos do conjunto conhecido, utilizando uma medida de similaridade. Depois, essas distâncias são organizadas da menor para a maior, permitindo identificar quais objetos estão mais próximos. Em seguida, selecionam-se os k vizinhos definidos para a análise. Por fim, a categoria do novo exemplo é determinada segundo o agrupamento ou a predominância dos rótulos encontrados entre esses vizinhos. Portanto, o resultado depende tanto das distâncias calculadas quanto do valor escolhido para k.
Q: Como a distância euclidiana é calculada no KNN?
A distância euclidiana é calculada a partir das diferenças entre as características do novo objeto e as do exemplo conhecido. Em um plano com x e y, calcula-se x2 menos x1 ao quadrado, soma-se y2 menos y1 ao quadrado e extrai-se a raiz quadrada do resultado. Se os dados tiverem uma terceira dimensão, acrescenta-se z2 menos z1 ao quadrado. O mesmo princípio continua para outras características, adicionando cada diferença quadrática dentro da raiz. Esse cálculo é repetido entre o objeto desconhecido e cada objeto disponível no conjunto.
Q: Por que a escolha do valor de k influencia a classificação?
O valor de k define quantos vizinhos próximos participarão da decisão. Se k for igual a 1, somente o rótulo do exemplo mais próximo será considerado. Com k igual a 2, pode ocorrer empate quando os dois vizinhos pertencem a classes diferentes. No exemplo apresentado, k igual a 3 produz dois votos para quadrado e um para círculo, classificando o novo objeto como quadrado. O conteúdo recomenda escolher um valor ímpar para reduzir a possibilidade de empate e também menciona a sugestão de usar log de n, sendo n o tamanho da base.
Q: Como o conjunto de flores Iris ilustra o funcionamento do KNN?
O conjunto de flores Iris é apresentado por meio da dispersão de combinações de medidas, como altura e largura da sépala e da pétala. O gráfico mostra que exemplos da mesma classe tendem a formar agrupamentos em regiões do plano cartesiano. As flores setosa aparecem concentradas e separadas, enquanto versicolor e virginica ficam mais próximas entre si, pois são descritas como flores parecidas. Essa organização visual sustenta a intuição do KNN: uma nova flor pode ser classificada comparando sua posição e sua proximidade com exemplos cujas classes já são conhecidas.
Q: O KNN pode ser usado para classificação e regressão?
Sim. O conteúdo afirma que uma vantagem do KNN é sua aplicação tanto em tarefas de classificação quanto de regressão, sem alterações significativas. Na classificação demonstrada, o algoritmo compara um novo objeto com exemplos rotulados, seleciona os k vizinhos mais próximos e usa suas classes para decidir o rótulo. A explicação concentra-se principalmente nesse uso classificatório, ilustrado por círculos, quadrados e flores Iris. Ainda assim, a possibilidade de regressão é apresentada explicitamente como outra utilização do mesmo método baseado na proximidade entre os dados disponíveis.
Q: Qual é o custo computacional do KNN ao classificar novos dados?
O KNN necessita de menos tempo de treinamento, mas pode apresentar custo computacional elevado quando precisa rotular um novo exemplo. Isso acontece porque o método depende do armazenamento e da recuperação dos dados usados como referência. Na pior hipótese descrita, o exemplo desconhecido precisa ser comparado com todos os exemplos contidos no conjunto de treinamento. Para cada comparação, calcula-se uma distância, e os resultados ainda precisam ser organizados para selecionar os vizinhos mais próximos. Assim, parte importante do trabalho é adiada até o momento em que a classificação é solicitada.
Q: Como implementar uma classificação KNN em Python?
A implementação apresentada utiliza o classificador de vizinhos do scikit-learn. Primeiro, importa-se o classificador e cria-se um objeto KNN, informando a quantidade de vizinhos mais próximos que será considerada. No exemplo, o valor usado é 3. Depois, fornecem-se ao treinamento as características dos exemplos e as classes dos objetos que já são conhecidos. Para classificar um novo objeto, chama-se o método predict e passa-se esse exemplo como entrada. O procedimento reproduz as etapas conceituais mostradas: usar dados rotulados, localizar vizinhos próximos e produzir a classe prevista.
Summary & Key Takeaways
-
O KNN usa a proximidade entre dados para realizar predições. No exemplo das flores Iris, medidas de altura e largura das sépalas e pétalas formam agrupamentos que ajudam a identificar a classe de uma nova flor.
-
Para classificar um objeto, o algoritmo calcula sua distância até cada exemplo conhecido, ordena os resultados da menor para a maior distância e considera somente os k elementos mais próximos para determinar a classe.
-
No Python, o KNN pode ser usado por meio do classificador de vizinhos do scikit-learn. Define-se a quantidade de vizinhos, treinam-se características e classes conhecidas e chama-se predict para o novo objeto.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚


Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator