Como preparar dados reais para inteligência artificial
TL;DR
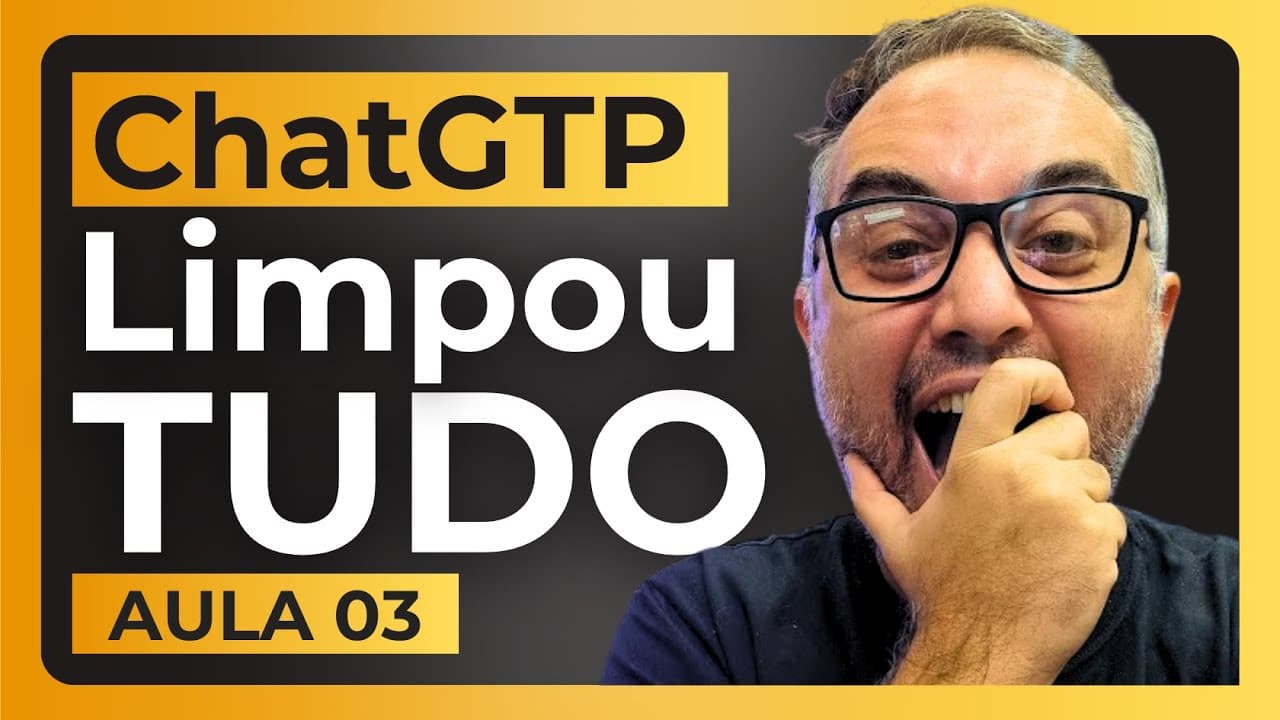
O pré-processamento é a etapa mais importante da ciência de dados porque informações ausentes, formatos inconsistentes e valores impossíveis comprometem qualquer análise ou modelo. Um formulário preenchido pela turma demonstra como identificar e tratar idades absurdas, horas negativas, campos vazios e respostas numéricas escritas de formas diferentes antes de combinar variáveis ou criar visualizações.
Transcript
bom é o que que é al né é aquela coisa você tem uma uma uma fábrica de bonecos todos bonitinhos bonitinhos de repente aparece uma al lá pronto É isso aí totalmente fora do padrão tô falando para você que é d do demônio é o Chuck brother eu tenho Unos Chuck bonitinho de repente da hora para outra aconteceu alguma coisa estranha o pré-processamento d... Read More
Key Insights
- O pré-processamento é apresentado como a tarefa mais importante da ciência de dados e da inteligência artificial.
- Dados ruins produzem resultados ruins, assim como um combustível inadequado compromete o funcionamento de uma máquina.
- Campos deixados em branco simulam informações ausentes que precisam ser identificadas e tratadas antes da análise.
- Idades de 100 e 2 anos foram inseridas deliberadamente para representar valores extremos ou incompatíveis com o grupo.
- Tempos de 36 e menos 5 horas em redes sociais exemplificam valores impossíveis que exigem validação.
- Respostas como 1 hora e meia, 02.20 e horários com dois-pontos mostram formatos inconsistentes na mesma variável.
- A limpeza permite combinar características, como idade, gênero e regime de trabalho, para estudar grupos específicos.
- Dados acadêmicos com notas 11 ou menos 1 ilustram como anomalias também aparecem em bases institucionais reais.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: Por que o pré-processamento é tão importante na ciência de dados?
O pré-processamento é considerado a tarefa mais importante porque os dados reais podem chegar incompletos, inconsistentes ou com valores impossíveis. O professor resume o problema pela ideia de que, se uma máquina recebe informações ruins, também produz resultados ruins. Antes de analisar respostas, criar visualizações ou aplicar inteligência artificial, é necessário encontrar campos vazios, padronizar formatos e decidir como lidar com anomalias. Sem esse tratamento, registros como idades absurdas, notas fora da escala e durações negativas podem distorcer as conclusões extraídas da base.
Q: Como o formulário foi usado para simular dados ausentes?
O formulário foi configurado sem perguntas obrigatórias, e cada participante recebeu a orientação de deixar exatamente uma questão sem resposta. A escolha do campo deveria variar aleatoriamente, evitando que todos omitissem a mesma informação. Com isso, a turma criou uma base contendo lacunas distribuídas por diferentes colunas. O exercício reproduz uma situação comum descrita pelo professor: bases reais não chegam completamente organizadas. A atividade permite observar os campos vazios e discutir como essas ausências precisam ser tratadas antes de qualquer análise dos participantes.
Q: Quais valores impossíveis foram inseridos de propósito na base?
Alguns participantes receberam instruções específicas para criar anomalias controladas. Marcelo deveria informar 100 anos de idade, Edson deveria registrar 2 anos, Rose deveria declarar 36 horas por dia nas redes sociais e Ana deveria indicar menos 5 horas. Esses números foram escolhidos para facilitar a identificação de valores incompatíveis ou impossíveis. Ao misturá-los às respostas normais da turma, o professor mostrou que a análise precisa reconhecer exceções, investigar seu significado e tratá-las antes de produzir agrupamentos, visualizações ou conclusões sobre o conjunto de dados.
Q: Que problemas de formato apareceram nas respostas numéricas?
As respostas sobre tempo apresentaram representações diferentes para a mesma ideia. Surgiram registros com dois-pontos, a expressão 1 hora e meia e o valor 02.20, cujo significado não estava claro para o professor. Também apareceu um registro de 20 horas. Embora a pergunta tratasse de um dado numérico, os participantes usaram formatos que não poderiam ser comparados diretamente sem interpretação e padronização. O exemplo demonstra que permitir escrita livre pode produzir valores ambíguos, mesmo quando as pessoas tentam responder a uma pergunta aparentemente simples.
Q: Como dados limpos permitem analisar grupos específicos?
Depois do tratamento, as variáveis podem ser combinadas para responder perguntas mais específicas do que a distribuição geral exibida pelo formulário. O professor cita a possibilidade de verificar o regime de trabalho entre as mulheres ou entre pessoas com menos de 20 anos. Também menciona a criação de faixas para participantes acima de 30 ou de 50 anos. Essas segmentações dependem de idades, gênero e regime de trabalho registrados de maneira utilizável. Se os valores estiverem vazios, absurdos ou em formatos incompatíveis, a comparação entre os grupos perde confiabilidade.
Q: Por que as visualizações gerais do formulário podem ser insuficientes?
As projeções automáticas do formulário mostram a distribuição geral de cada coluna, o que já permite observar tendências como a presença do trabalho em regime de home office. Porém, elas não respondem diretamente a questões que combinam duas ou mais características. Para saber como o regime de trabalho se distribui entre mulheres ou em determinadas faixas etárias, é necessário relacionar colunas e possivelmente criar novas visualizações. O professor considera desnecessário repetir gráficos gerais no ChatGPT, mas reconhece utilidade quando a análise precisa cruzar variáveis e separar subconjuntos.
Q: Como bases acadêmicas ilustram problemas reais de qualidade dos dados?
O professor relata ter encontrado valores como nota 11 e nota menos 1 em uma base de notas do IFG. Esses registros mostram que sistemas institucionais também podem conter números fora do intervalo esperado, assim como o formulário criado para a aula. Ele relaciona esse problema a projetos de inteligência artificial usados para estimar se um aluno recém-matriculado deixaria o curso ou se reprovaria. Para que previsões desse tipo sejam analisadas adequadamente, a base precisa ser examinada e tratada, pois anomalias nas notas podem alterar o resultado produzido.
Q: O ChatGPT substitui o trabalho de preparação dos dados?
O relato não apresenta o ChatGPT como substituto automático do pré-processamento. Um participante comenta que tentou usar um prompt para organizar uma base de preços de imóveis de São Paulo, mas o próprio resultado indicou que seria preciso tentar novamente. O professor também diz que não faria no ChatGPT as plotagens gerais já oferecidas pelo formulário, embora pudesse usá-lo para combinações mais específicas. Assim, o material mostra o ChatGPT como possível apoio para análise e visualização, enquanto a identificação, interpretação e correção dos problemas continuam necessárias.
Summary & Key Takeaways
-
O professor cria um formulário sem perguntas obrigatórias e orienta cada participante a deixar exatamente uma resposta vazia, simulando a falta de informações encontrada em bases de dados reais.
-
Alguns alunos recebem valores deliberadamente impossíveis, como 100 ou 2 anos de idade, 36 horas diárias nas redes sociais e menos 5 horas, para testar a identificação de anomalias.
-
As respostas mostram problemas como campos vazios e durações registradas como 1 hora e meia, 02.20 ou com dois-pontos, exigindo limpeza antes de segmentações, gráficos e modelos de inteligência artificial.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚

Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator