高性能な生成AIのトークン料金を節約する方法
TL;DR
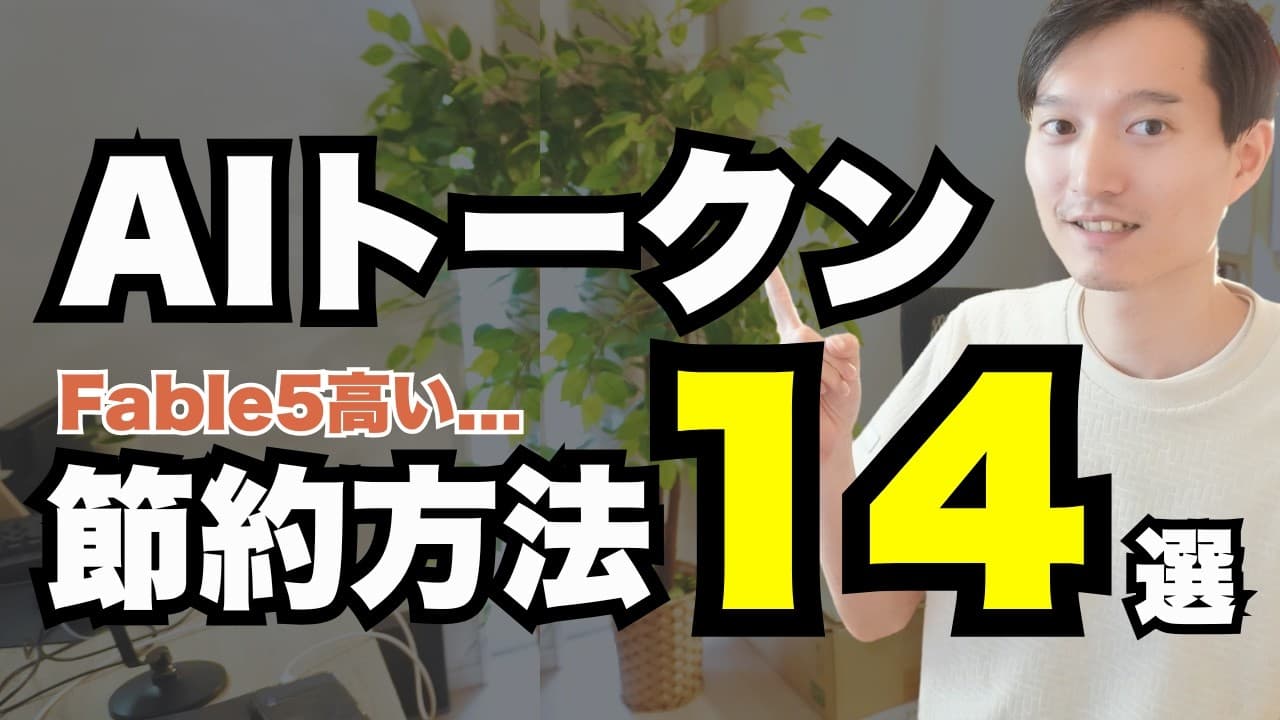
トークン料金は、使用量の可視化、不要な会話履歴や接続機能の削減、出力文字数の制限によって抑えられる。さらに、タスクの難易度に応じてモデルとエフォートを使い分け、再利用する資料はプロジェクト機能やメモリで効率化する。
Transcript
はい、こんにちは。ケトです。この チャンネルは生成の最新情報や活用事例を 紹介してます。是非チャンネル登録どお 願いいたします。そして今回のテーマは 最近の最高レベルのAIモデルに関してな んですけど、そのAIモデル、ま、例えば FA5とか今後出てくるであろうチャAT GPTの新しいモデルGPT5.6 ウルトラソルとかかな。え、その辺りの モデルってものすごく金額が高いじゃない ですか。え、なので最近のこのAI界隈と いうかAIを使ってるユーザーの人たちで すごくね、旬になってるのはAIの料金を どういう風に節約していくか、すなわち AIで使っていくトークンをどう節約して いくかっていうのがですね、結構議論され ていて、え、話題になってましたので、え 、今回この動画では私が思い当たる限りの ... Read More
Key Insights
- ・使用量の可視化は、トークン節約の出発点である。各セッションで消費した割合だけでなく、概算金額を通知や表示で確認すると、高コストな使い方を把握しやすくなる。ただし表示額は明確な請求額ではない。
- ・新しい話題で会話履歴を残すことは、不要な入力トークンを増やす要因である。AIは過去のやり取りを読み込んで回答するため、文脈が不要ならクリアコマンドで新しい会話に切り替えると節約できる。
- ・関連作業を一度の指示へまとめることは、会話の往復を減らす方法である。構成、資料、画像、説明原稿をまとめて依頼できるが、品質が不足する場合は二回以上に分け、指示回数との均衡を取る必要がある。
- ・エフォート設定は、内部で考える量とトークン消費を左右する。単純な文章整理では低い設定、アプリ制作のような重い作業では高い設定を選び、必要以上に長い思考を発生させないことが重要である。
- ・不要なコネクターを有効にしたままにすることは、関係のない情報探索につながり得る。GmailやGoogleドライブなどに答えがない作業では接続をオフにし、探索と読み込みによる消費を避ける。
- ・出力条件の数値化は、回答側のトークンを抑える直接的な方法である。「300文字以内」や項目数などを指定し、画像生成用プロンプトを含む中間出力も必要十分な長さにすると無駄を減らせる。
- ・添付資料の範囲指定は、入力トークンの削減に有効である。PDF、PowerPoint、Excelを丸ごと渡さず、レポート作成に必要なページ、シート、列などを伝えるか、必要部分だけを抽出して渡す。
- ・タスク別のモデル分担は、高性能モデルの利用範囲を絞る方法である。計画や技術的に難しい部分だけ高性能モデルへ任せ、実行や確認は別のモデルとエフォートに割り当てることで無駄遣いを抑える。
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: 生成AIのトークン料金を節約する最初の方法は?
最初に各セッションの使用量を確認し、どの操作で消費が増えたかを把握します。動画では、使用割合に加えて概算金額を通知や画面に表示する仕組みが紹介されています。ただし、その金額は明確な請求額ではなく、仮に従量課金した場合の感覚をつかむ目安として扱う必要があります。
Q: 新しい話題では同じチャットを続けない方がよいのはなぜですか?
過去の文脈が不要な新しい話題では、別の会話に切り替える方が入力トークンを抑えやすくなります。同じチャットで往復を重ねると、AIは初期の会話から蓄積された文脈を読み込んで次の回答を作るためです。一方、過去の経緯が回答に必要なら、節約だけを優先せず会話を継続します。
Q: クリアコマンドでトークンを節約する方法は?
新しい作業を始める前にクリアコマンドを使い、不要になった会話の文脈を外します。これにより、前の話題を毎回読み込ませず、真っさらな状態で依頼できます。ただし、直前の判断や成果物を引き継ぐ作業では情報が失われるため、文脈が必要かどうかを確認してから使用します。
Q: 複数の作業を一度の指示にまとめる方法は?
相互に関連する工程を最初の指示に並べ、可能な範囲で一度に実行させます。動画の例では、資料の構成案、スライド、画像やインフォグラフィック、説明用トークスクリプトをまとめて依頼します。一度で品質が出ない場合は二回、さらに難しければ工程別に分け、品質と節約の均衡を取ります。
Q: エフォートレベルはどのように設定すればよいですか?
作業の難易度に応じて、必要最低限のエフォートを選びます。文章を箇条書きにするような単純作業は低い設定でも対応できる一方、専用アプリの制作など重い作業では高い設定が候補になります。高くするほど考える時間にもトークンを使うため、常に最高設定にせず結果を見ながら調整します。
Q: 不要なコネクターをオフにすると何が節約できますか?
依頼と関係のない外部サービスを探索する処理や、その情報を読み込むトークンを減らせます。動画では、接続済みのGmailやGoogleドライブなどに手掛かりがあるとAIが推測し、情報を探しに行く例が示されています。対象サービスに答えがない作業では、不要なコネクターをオフにします。
Q: AIの出力トークンを短くする指示方法は?
回答の文字数、項目数、形式を具体的に指定します。例えば「300文字以内」のように上限を示せば、最終回答の量を人間側から調整できます。画像生成用のプロンプトなど、別の処理へ渡す中間出力も不必要に長くしないことが重要です。ただし、必要な詳細まで削らない範囲で短縮します。
Q: PDFやExcelを添付するときにトークンを節約する方法は?
ファイル全体ではなく、作業に必要な部分だけをAIへ渡します。Excelからレポートを作るなら対象のシート、列、範囲を明示するか、その部分だけを抽出したデータを用意します。PDFやPowerPointも同様です。ファイル全体を読み込ませると、使わない内容にも入力トークンが発生するためです。
Q: プロジェクト機能はトークン節約にどう役立ちますか?
繰り返し利用するPDFやPowerPointなどをプロジェクト機能へ置くことで、動画で説明されるキャッシュの効果を利用できます。一度読み込んだ内容が一時保存された状態になり、同じ資料を再び扱う際の効率向上が期待されます。毎回使う資料を、その都度新しいチャットへ添付する運用の代替になります。
Q: メモリ機能はオンにした方がよいですか?
同じ案件や似た依頼を何度も扱う場合は、オンにすると背景説明の繰り返しを減らせます。過去のやり取りを踏まえて新しいタスクへ進めるためです。ただし、同じAIへ多様な仕事を依頼すると、別案件の記憶が邪魔になる可能性があります。反復説明の削減効果と、不要な記憶の影響を比較して選びます。
Q: サブエージェントで高性能モデルの料金を抑える方法は?
作業を計画、実行、確認などに分け、難しい工程だけ高性能モデルへ割り当てます。動画では、重要な計画を高性能モデルに任せ、実行や軽い確認を別のモデルとエフォートで処理する考え方が示されています。すべての工程へ高価なモデルを使わず、必要な部分だけ能力を利用する方法です。
Summary & Key Takeaways
-
最初に、各セッションの使用量を確認し、概算金額まで可視化する。新しい話題ではクリアコマンドで過去の文脈を外し、構成案、資料、画像、トークスクリプトなどの関連作業は、品質を確認しながら可能な範囲で一度の指示にまとめる。これにより、過去の会話を毎回読み直す入力コストと、細かな往復で増えるトークンを抑えられる。
-
次に、タスクの難易度に合わせて思考のエフォートと使用モデルを調整する。箇条書き化などの軽い作業は低い設定、アプリ開発などの重い作業は高い設定が候補になる。不要なコネクターはオフにし、回答の文字数や項目数も明示する。PDF、PowerPoint、Excelは丸ごと渡さず、必要なページ、列、範囲だけを抽出して入力を減らす。
-
継続利用する資料はプロジェクト機能へ置き、キャッシュの効果を利用する。同じ案件の説明を繰り返す場合はメモリも役立つが、異なる仕事の記憶が邪魔になる可能性との比較が必要である。さらに、計画、実行、確認を分解し、難しい部分だけ高性能モデルに任せる。動画ではコンパクトコマンド、外部圧縮ツール、画像読み取りの制限、AIエージェントの使い分けも節約策として挙げている。
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from KEITO【AI&WEB ch】 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator