Como o RLM amplia a janela de contexto com LLMs
TL;DR
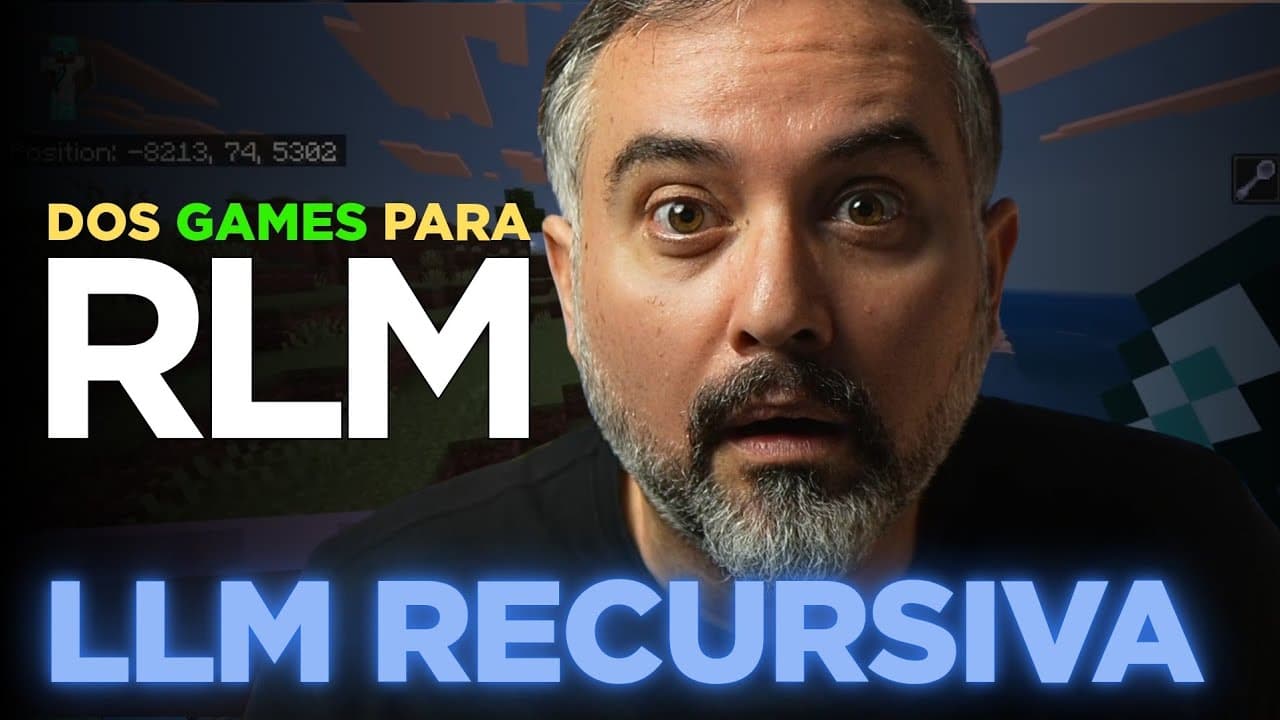
A ideia central é usar o RLM, uma técnica que recursivamente escreve código para lidar com textos grandes, carregando informações sob demanda. A degradação de contexto ocorre quando a quantidade de dados excede a janela de memória. O vídeo mostra a analogia com jogos, explica o funcionamento do RLM e demonstra uma aplicação prática em Python com exemplos e links úteis.
Transcript
Qual a relação entre os games como Minecraft, GTA, Assassin's Creed, Red Dead Redemption e Cyberpunk com uma nova técnica de gerenciamento de contexto em LLMs? Como você sabe muito bem, o mundo dos games nos deram as GPUs e sem as GPUs nós não teríamos a IA como nós temos hoje. Só que agora tem uma virada curiosa. Um truque que esses games usam pod... Read More
Key Insights
- A degradação de contexto acontece mesmo com janelas grandes, especialmente em tarefas de transformar e parear informações.
- O RLM funciona como um carregamento por partes sob demanda, semelhante a como jogos abrem partes do mundo conforme necessário.
- A LLM escreve código para manipular o contexto e executa recursivamente ações usando uma estratégia map reduce.
- A analogia com jogos ajuda a entender como manter apenas informações relevantes na memória.
- O modelo recursivo pode chamar a si mesmo para processar subpartes do contexto, aumentando capacidade efetiva.
- A técnica combina um ambiente de programação (Python) com prompts que guiam a extração de evidências.
- O método busca resultados parciais que são combinados para a resposta final, evitando sobrecarga.
- A prática inclui demonstração prática no código e referências de uso real, como repositórios GitHub.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: O que é degradação de contexto em LLMs e por que ela importa?
Degradação de contexto é o fenômeno em que, mesmo com janelas de contexto grandes, a qualidade das respostas cai ao lidar com volumes elevados de informação. Esse problema se torna crítico em tarefas que exigem transformar, agrupar ou parear informações ao longo de textos extensos. A ideia apresentada no vídeo é mostrar que simplesmente aumentar a janela não resolve o problema para essas tarefas, pois o modelo pode perder relevância e coerência ao tentar processar tudo de uma vez. Compreender essa degradação é essencial para desenvolver estratégias eficientes de gerenciamento de contexto e manter a precisão das respostas.
Q: Como o RLM propõe contornar a degradação de contexto?
O RLM propõe contornar a degradação de contexto por meio de carregamento sob demanda e de uma abordagem recursiva. Em vez de inserir todo o texto na janela de contexto, o modelo escreve código para manipular o contexto, divide o problema em partes, e executa chamadas recursivas a si mesmo para processar subpartes do material. Essa técnica de map reduce permite que o modelo busque, leia e processe apenas o que é relevante para a pergunta atual, mantendo o desempenho mesmo com textos muito grandes.
Q: Qual é a analogia com jogos usada para explicar o RLM?
A analogia usa jogos de mundo aberto para explicar o carregamento sob demanda de informações. Assim como em jogos nós carregamos apenas a área próxima ao jogador para evitar travamentos, o RLM carrega apenas textos relevantes para a pergunta atual. Essa comparação ajuda a entender como o contexto pode ser gerenciado de forma eficiente, permitindo que o modelo utilize informações extensas sem ficar sobrecarregado, mantendo a qualidade da resposta.
Q: Quais são os componentes básicos de um RLM, conforme o vídeo?
Os componentes básicos são: um modelo de linguagem para raciocínio, um ambiente de programação (neste caso Python) para manipular o contexto, e um prompt mantido em uma variável que orienta as operações a serem executadas pelo modelo. O modelo escreve códigos que são executados para gerenciar o contexto, e as chamadas recursivas permitem que o modelo trate partes do texto de forma incremental, retornando resultados parciais que são integrados na resposta final.
Q: Como funciona a recursão no RLM, segundo a explicação?</
A recursão no RLM ocorre quando o próprio modelo chama a si mesmo para executar uma ação sobre uma parte do texto. Por exemplo, ele pode pedir a si mesmo para extrair itens de um capítulo específico, depois solicitar que outra chamada do modelo procure itens adicionais. Esse ciclo continua até alcançar uma etapa de parada que culmina na resposta final. Esse fluxo é semelhante a uma função recursiva na programação e é o que habilita o processamento de grandes volumes de dados sem exceder a janela de contexto.
Q: Quais tarefas foram usadas para demonstrar a degradação do contexto no estudo citado?
As três missões são: buscar a agulha no palheiro, ou seja, localizar informações específicas dentro de um texto; transformar e agrupar informações ao longo de todo o texto; transformar, agrupar e parear essas informações, ou seja, formar pares relevantes. O estudo mostrou que a busca funciona bem, mas a transformação e o pareamento degradam rapidamente conforme o volume de texto cresce. Esses casos ilustram diferentes aspectos do desafio de manter qualidade com janelas grandes.
Q: Quais recursos o vídeo indica para aprofundar o tema e praticar a técnica?
O vídeo menciona o repositório GitHub do projeto RLM, https://github.com/alexzhang13/rlm, como referência prática para implementação. Além disso, aponta um grupo de WhatsApp para discussão, com link na descrição, oferecendo suporte da comunidade para quem quer aplicar a técnica, discutir dúvidas e compartilhar códigos. Também há menção a um livro e mentoria sobre gestão de contexto, com conteúdos adicionais e exercícios.
Q: Qual é o papel do ambiente de programação no RLM e como ele é utilizado?
O ambiente de programação, neste caso Python, é essencial para que o modelo de linguagem execute código que manipula o contexto. O RLM não depende apenas de textos; ele gera e executa scripts que reduzem o contexto a partes relevantes, com chamadas recursivas que consultam o próprio modelo para cada subproblema. Esse aspecto transforma o processo de leitura de textos extensos em uma sequência de tarefas manejáveis, cada uma com evidências e resultados intermediários.
Summary & Key Takeaways
-
O vídeo apresenta a degradação de contexto em LLMs quando textos grandes são usados, destacando que aumentar a janela não resolve o problema para todas as tarefas. Em resposta, o RLM utiliza carregamento sob demanda e recursão para manter desempenho.
-
É traçada a analogia com jogos de mundo aberto, onde apenas a área próxima ao jogador é carregada, inspirando a ideia de carregar apenas informações relevantes para a pergunta atual.
-
Ao final, o apresentador detalha a construção de um código em Python que executa a técnica, além de indicar recursos adicionais como GitHub e um grupo de WhatsApp para aprofundar o estudo.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator