Como analisar grupos do WhatsApp com agentes GPT
TL;DR
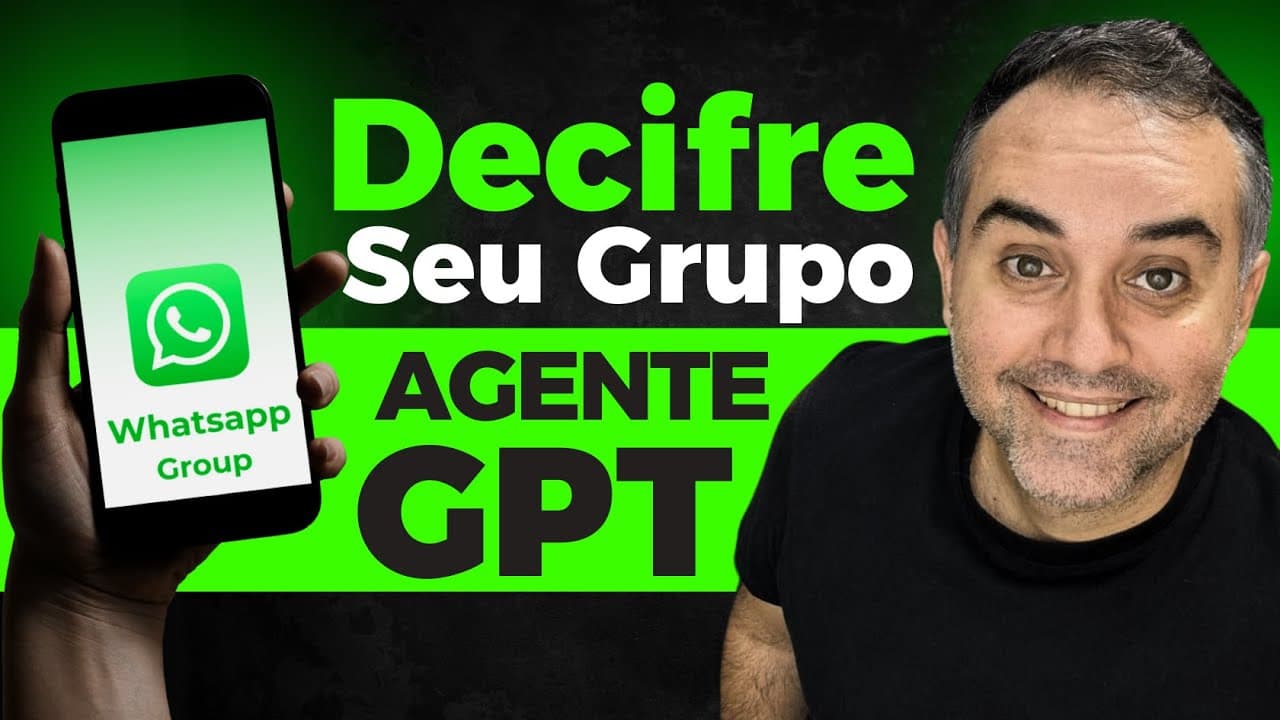
Exporte as conversas do WhatsApp em TXT, envie o arquivo ao GPT personalizado e execute, em etapas, agentes Python que reconhecem registros, classificam ações e limpam mensagens. Depois do pré-processamento, é possível identificar participantes ativos e inativos, horários de maior atividade, distribuição semanal, palavras frequentes e outros padrões úteis para administrar o grupo.
Transcript
analisando grupos de WhatsApp com inteligência artificial eu aposto que você participa de algum grupo de WhatsApp que seja na sua empresa com clientes na faculdade ou o famoso grupo da família hoje eu vou mostrar para você Como você pode se tornar um detetive digital revelando tendências padrões e até mesmo o comportamento oculto dos membros do seu... Read More
Key Insights
- O arquivo TXT exportado do WhatsApp funciona como a entrada das conversas para o GPT personalizado.
- Dez agentes Python dividem o pré-processamento em reconhecimento, ações de usuários e limpeza textual.
- O processamento por códigos separados oferece mais consistência do que solicitar toda a limpeza por um prompt.
- As pausas entre os agentes evitam sobrecarga, e o usuário retoma cada etapa escrevendo “continue”.
- A análise contabiliza mensagens e identifica participantes que entraram, saíram ou enviaram mídia oculta.
- Usuários ativos são definidos no exemplo como aqueles que enviaram ao menos uma mensagem em seis meses.
- A distribuição temporal revelou quinta-feira como o dia mais ativo e 17 horas como o pico do grupo analisado.
- O arquivo de stopwords remove termos pouco informativos e pode receber novas palavras escolhidas pelo usuário.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: Como analisar conversas de um grupo do WhatsApp com um GPT personalizado?
Primeiro, exporte as conversas do grupo do WhatsApp como um arquivo TXT. Em seguida, envie esse arquivo ao GPT personalizado apresentado. O sistema renomeia e prepara o conteúdo antes de executar os agentes Python responsáveis pelo pré-processamento. Como a conversa pode ser extensa e desorganizada, a execução é dividida em etapas. Quando cada fase termina, o usuário escreve “continue” para iniciar a próxima. Depois da leitura, classificação das ações e limpeza das mensagens, o GPT fica pronto para responder a pedidos de análises, tabelas, gráficos e nuvens de palavras.
Q: Por que o pré-processamento das conversas é dividido entre vários agentes?
A divisão existe porque conversas extensas do WhatsApp contêm nuances, registros de ações e mensagens com elementos que dificultam uma limpeza consistente por um único prompt. O projeto usa dez agentes organizados em três grupos de tarefas: leitura e reconhecimento das informações do TXT, identificação das ações realizadas pelos participantes e tratamento das mensagens. Os últimos agentes removem a sujeira textual e estruturam os dados em arquivos manipuláveis. Essa separação também permite inserir pausas entre as fases, reduzindo a possibilidade de o ChatGPT travar durante uma análise longa e pesada.
Q: Quais informações os agentes extraem do arquivo de conversas?
Os agentes reconhecem as informações presentes no arquivo TXT, identificam ações dos usuários e limpam o conteúdo das mensagens. Entre as ações observadas estão entrada no grupo, saída, remoção e envio de mídia oculta. Isso permite calcular quantas pessoas entraram, quantas saíram e quantas permanecem no grupo. No conteúdo textual, o processo pode remover links, emojis, stopwords e outros elementos considerados sujeira para a análise proposta. Após essa preparação, os dados ficam armazenados em arquivos que podem ser usados para produzir contagens, tabelas, gráficos e análises por participante ou período.
Q: Como identificar usuários ativos e inativos no grupo?
No exemplo apresentado, um usuário ativo é quem enviou pelo menos uma mensagem no grupo durante os últimos seis meses. Um usuário inativo é alguém que entrou, mas nunca publicou mensagem. Com os dados processados, o GPT pode contar esses dois grupos, criar um gráfico de pizza e listar os participantes mais antigos que continuam inativos. A demonstração encontrou 44% de usuários ativos, enquanto mais da metade permanecia apenas observando. Também foi solicitada uma tabela com os 20 usuários inativos mais antigos, incluindo a data de entrada, sem exibir publicamente os respectivos telefones.
Q: Como descobrir os melhores dias e horários para publicar no grupo?
Depois do pré-processamento, solicite uma distribuição das mensagens por dia da semana e outra por hora. O GPT contabiliza as publicações e cria gráficos que mostram quando a conversa é mais intensa. No grupo usado na demonstração, quinta-feira apareceu como o dia mais ativo, o período da tarde concentrou mais atividade e 17 horas foi o pico de mensagens. O apresentador também observou atividade relevante até 22 horas e sugeriu que uma comunicação ou lançamento poderia ser feito perto das 17 horas, por exemplo entre 16h30 e 16h45, com base nesse padrão específico.
Q: Como criar uma nuvem de palavras das mensagens do WhatsApp?
O usuário pode pedir ao GPT uma nuvem de palavras baseada em todas as mensagens ou em um recorte específico, como determinado dia da semana, uma data ou o dia mais ativo do histórico. Na demonstração, foi solicitada uma nuvem com as 30 palavras principais do dia que concentrou mais mensagens. Como a primeira versão pode destacar termos pouco informativos, o processo aceita um arquivo de stopwords. Esse arquivo é aplicado à nuvem para excluir palavras indesejadas e preservar termos mais úteis para compreender os assuntos que apareceram nas conversas selecionadas.
Q: O que são stopwords no processo mostrado e como personalizá-las?
No fluxo apresentado, stopwords são palavras consideradas pouco informativas para a nuvem de palavras e para a interpretação do conteúdo. O arquivo fornecido contém vários desses termos e também pode eliminar expressões decorrentes do próprio registro do WhatsApp, como “mídia oculta”, usada quando alguém envia uma figurinha, um vídeo ou outro conteúdo desse tipo. O usuário pode abrir o arquivo, adicionar as palavras que não deseja considerar, salvar a nova versão e enviá-la novamente ao ChatGPT. O sistema lê a lista atualizada, exclui esses termos e recria a visualização com palavras mais relevantes.
Q: Por que é necessário escrever “continue” durante a execução dos agentes?
O comando “continue” controla o avanço entre as fases do processamento. Após receber e preparar o TXT, o GPT executa o primeiro agente e informa que a tarefa pode levar algum tempo. Quando uma etapa é concluída, o usuário envia “continue” para iniciar o código seguinte, incluindo a análise detalhada, o reconhecimento das ações e a limpeza das mensagens. Segundo a explicação, seria possível solicitar a execução sequencial de todos os agentes, mas isso provavelmente faria o ChatGPT travar durante a análise. As pausas deixam o trabalho dividido e dão tempo para o sistema processar cada conjunto de tarefas.
Summary & Key Takeaways
-
O fluxo começa com a exportação das conversas do WhatsApp em um arquivo TXT. O usuário envia esse arquivo ao GPT personalizado, que aciona códigos Python organizados como agentes especializados.
-
Dez agentes divididos em três grupos reconhecem informações, classificam ações dos participantes e limpam as mensagens. A execução em etapas, confirmada com o comando “continue”, reduz o risco de travamento.
-
Após o processamento, o GPT produz tabelas, gráficos e nuvens de palavras. As análises mostram usuários ativos ou inativos, entradas e saídas, dias e horários movimentados e termos mais frequentes.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚

Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator