Como funcionam a indexação e o retriever no RAG?
TL;DR
O RAG prepara uma base de textos e recupera os trechos relevantes para fundamentar respostas às perguntas do usuário. A indexação divide o conteúdo em chunks, gera embeddings e armazena essas representações em uma base vetorial. Durante a consulta, o retriever busca e seleciona os trechos relacionados à pergunta, enquanto novas informações podem ser incorporadas à base com o sistema em uso.
Transcript
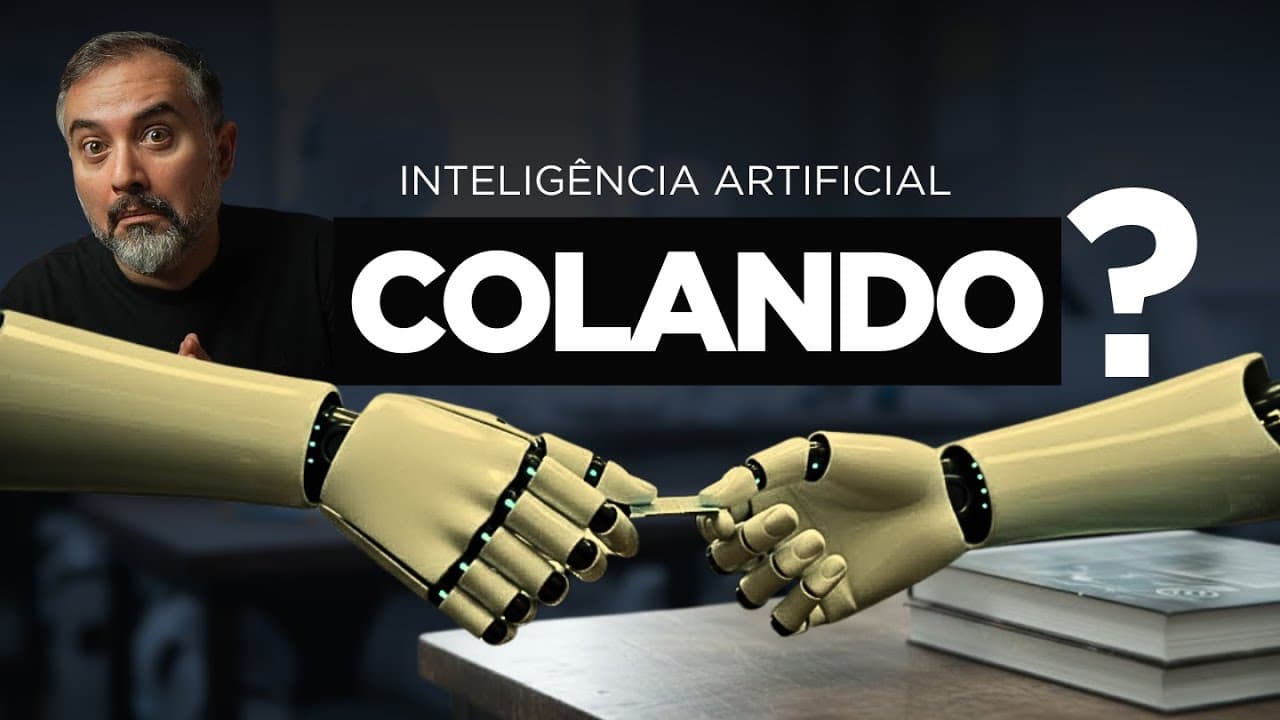
Se você olhar pro processo humano, você consegue responder basicamente quase todas as perguntas em relação à inteligência artificial. Veja bem, eu falei que o Rag é como se fosse uma cola que você leva pra prova quando você vai responder alguma coisa. Concorda? Esse momento aqui em cima é o momento, digamos assim, onde você vai preparar a cola. Por... Read More
Key Insights
- A indexação prepara os textos que o RAG usará como apoio para responder às perguntas dos usuários.
- Os chunks são partes do texto, comparadas no vídeo aos pequenos bilhetes de uma cola de prova.
- Os embeddings representam uma codificação dos conteúdos preparados para uso na base vetorial.
- A etapa online corresponde ao momento em que o usuário faz perguntas e consulta o conhecimento.
- A base de conhecimento pode receber informações novas enquanto os usuários continuam pesquisando.
- O padrão produtor-consumidor ilustra a separação entre preparar informações e utilizá-las nas consultas.
- O retriever gera o embedding da pergunta e busca na base vetorial os chunks relacionados à consulta.
- A quantidade de trechos recuperados pode ser definida pelo desenvolvedor ou escolhida pelo usuário.
Install to Summarize YouTube Videos and Get Transcripts
Explore YouTube Video Summarizer or Get YouTube Transcript Extractor
Questions & Answers
Q: O que é RAG e como a analogia da cola de prova ajuda a entendê-lo?
O RAG é apresentado como um sistema que consulta informações preparadas previamente para apoiar suas respostas. A analogia utilizada é a de uma pessoa que organiza uma cola antes de fazer uma prova. O livro corresponde aos textos disponíveis, os bilhetes representam os chunks e os bolsos ilustram o armazenamento dessas informações. Quando surge uma pergunta, a pessoa procura o bilhete relacionado ao assunto para fundamentar a resposta. Essa comparação ajuda a distinguir a preparação do material da sua utilização e mostra por que a base precisa conter informações antes de ser consultada.
Q: Como funciona o processo de indexação em um sistema RAG?
A indexação é a etapa de preparação das informações que serão consultadas pelo sistema RAG. O processo começa com o corpus, descrito como o conjunto de textos que serviria de material de estudo. Esses textos passam por pré-processamento e são separados em partes chamadas chunks. Em seguida, o conteúdo recebe uma representação por embeddings e é armazenado na base vetorial. Na analogia da prova, essa sequência corresponde a ler o livro, organizar os bilhetes e guardá-los para encontrar o material necessário quando uma pergunta aparecer. A indexação prepara, portanto, o conhecimento disponível para recuperação.
Q: Por que a indexação do RAG é chamada de offline?
A indexação é chamada de offline porque corresponde à preparação do material que o sistema usará nas consultas. O vídeo compara essa etapa ao momento em que uma pessoa está em casa organizando a cola antes da prova. A etapa online corresponde à prova acontecendo, quando as perguntas precisam ser respondidas com o material disponível. Essa distinção identifica funções diferentes dentro do processo. O próprio exemplo apresentado também mostra que novos conteúdos podem ser preparados e inseridos na base enquanto usuários fazem consultas, pois a produção das informações e seu consumo são tratados como processos separados.
Q: O que são chunks e embeddings na preparação de uma base RAG?
Chunks são as partes em que o texto é dividido durante a preparação da base de conhecimento. No vídeo, eles são comparados a bilhetes nos quais uma pessoa registra informações para consultar durante uma prova. Os embeddings são apresentados como uma codificação desses conteúdos, usada no sistema vetorial. A base vetorial aparece na analogia como os bolsos onde os bilhetes são guardados por assunto. Quando chega uma pergunta, o retriever também gera um embedding para ela e busca os chunks relacionados. Assim, a explicação conecta a divisão dos textos à representação utilizada para recuperar o material pertinente.
Q: É possível atualizar a base de um RAG enquanto os usuários fazem consultas?
Sim, a explicação apresentada permite incorporar novas informações à base de conhecimento enquanto os usuários continuam fazendo consultas. O exemplo é uma empresa de notícias que já possui conteúdos armazenados e recebe novas notícias durante o funcionamento do sistema. A preparação desses conteúdos produz informações para a base, enquanto as consultas consomem o material disponível. O vídeo relaciona essa separação ao padrão produtor-consumidor e usa a comparação entre uma granja que produz ovos e um supermercado onde eles são comprados. A ideia central é que a atualização do conhecimento não exige interromper o atendimento às perguntas.
Q: Qual é a diferença entre atualizar informações no RAG e fazer fine-tuning?
No RAG, a atualização descrita consiste em preparar novas informações e incorporá-las à base de conhecimento que o sistema consulta. Dessa forma, o conteúdo pode ficar disponível para os usuários à medida que é inserido. O fine-tuning é apresentado como um processo que envolve treinamento offline e posterior substituição da inteligência artificial utilizada. A explicação ressalva que isso não significa necessariamente parar o serviço durante o treinamento. A diferença destacada está no caminho de atualização: o RAG recebe conteúdo na base consultável, enquanto o fine-tuning exige o movimento de treinamento antes da substituição do modelo.
Q: Qual é o principal objetivo do retriever em um sistema RAG?
O principal objetivo do retriever é encontrar os trechos de texto relacionados à pergunta do usuário e selecionar os mais relevantes. Na sequência apresentada, ele recebe a consulta, gera seu embedding e busca na base vetorial os chunks que podem ajudar a respondê-la. O exemplo utilizado envolve um livro com um capítulo sobre agentes: uma pergunta sobre o que é um agente deve recuperar os trechos que tratam dessa definição. A recuperação, portanto, envolve tanto localizar conteúdo relacionado quanto escolher o material mais importante para a pergunta, evitando trazer todos os textos que possam ter alguma relação com o assunto.
Q: Como definir quantos trechos o retriever deve recuperar para uma pergunta?
A quantidade de trechos recuperados pode ser configurada pelo desenvolvedor que implementa o retriever. O vídeo apresenta exemplos de trazer cinco, dez ou quinze textos relevantes, em vez de retornar uma quantidade maior de resultados relacionados. Essa escolha também é associada ao tamanho do contexto do modelo que vai gerar a resposta. Outra possibilidade mencionada é oferecer esse controle ao usuário, permitindo que ele solicite quantos trechos relacionados deseja receber. O objetivo da configuração é selecionar uma quantidade de conteúdo pertinente à pergunta, mantendo a recuperação concentrada nos textos considerados mais relevantes.
Summary & Key Takeaways
-
A indexação prepara o conhecimento usado pelo RAG: os textos são pré-processados, divididos em chunks e representados por embeddings. Esse material fica armazenado na base vetorial para consultas posteriores.
-
O vídeo distingue a preparação dos dados da consulta: a indexação produz informações e o atendimento às perguntas as consome. Novos conteúdos podem entrar na base enquanto os usuários continuam pesquisando.
-
O retriever recebe a pergunta, gera seu embedding e busca chunks relacionados na base vetorial. A quantidade de trechos recuperados pode ser definida pelo desenvolvedor ou disponibilizada ao usuário.
Read in Other Languages (beta)
Share This Summary 📚
Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator
Explore More Summaries from Sandeco 📚

Summarize YouTube Videos and Get Video Transcripts with 1-Click
Try YouTube Summary with ChatGPT & Claude or YouTube Transcript Generator